

dsh-degeneration-kit
Discovered★ 9DSH 防退化套件|不止打断,还会清创:把退化的思考块从模型可见历史里折叠掉,下一轮不再回传。复读分两型——A 型同一句死磕、B 型短句轮换(最难抓,实测英文 8 块全漏)。两个插件一套闭环,缺一个都会漏。
DSH 防退化套件 —— ⚠️ 两个插件,两个都得装才完整
English | 中文
上下文越长,模型越容易陷进「我要做 X」的空转(复读),而且回合看起来还是成功的, 不加检测根本发现不了(本机实测:24 个真退化块里 18 个回合正常结束,只在思考里烂)。
这个仓库里有两个插件,各治一半:
- 少产生 ——
thinking-guard:把退化的思考块从模型可见的历史里折叠掉,不让它每轮重放;- 清库存 ——
dsh-auto-checkpoint:到水位压缩(把已经累积的污染整体清掉),或换一个新会话。缺一个都会漏(理由见下表后面的三条)。只装一个也比裸奔强,但要真想彻底解决,两个都要装。
复读长什么样:两种形态,判据完全不同
「复读」不是一种东西。我们把本机 493 个会话日志里全部 reasoning 块按同一个口径过了一遍
(ra = 同一段里同一句的最高重复次数),它们分成两类:
| A 型 · 同一句死磕 | B 型 · 短句轮换 | |
|---|---|---|
| 重复次数 | 10³–10⁴ | 20–200 |
| 上下文 | 短(29k–42k) | 长,随长度单调上升 |
| 典型样子 | (读×3369、做×1024、「好」×10848 | Let me write it. → Go. → Now. → OK. |
| 读起来像 | 正常思考:有主语、有下一步动作、句句合规,信息量为 0 | 正常推进 —— 最难认出来的就是它 |
| 多不多 | 罕见(中文单元全机 5 例) | 常见 |
| 跟模式的关系 | 只在「强制中文思考」的模式里见过(其它 31 个会话:0 例) | 无关 |
⚠️ 两条容易搞反的:
- 「中文更容易退化」是体感,不是数据。 成立的是「最严重的案例全是中文」(差 1–2 个数量级); 按数量算,最常见的是英文碎片型。体感记住的是最扎眼的那一个,不是最多的那一个。
- 中文那 5 例全部出现在同一个模式里,所以「是中文的锅」还是「那套格式约束的锅」, 我们分不开 —— 别把相关当因果。
B 型为什么特别难抓:判据原本要求「单个单元占窗口句数 ≥20%」,而轮换让每个短词只占 ~15%,
没有一个够门槛 ⇒ 整块放行。实测:英文为主的 8 个块全被这道门拦掉。
这就是第二把尺子 rotationGuard 存在的原因(细节见 thinking-guard/README.md)。
为什么复读会自己喂自己:DSH 会把历史里的 reasoning 块原样回传上游。
所以一条复读不只是一步出错 —— 它留在上下文里,之后每一步都再发一遍,
模型读到的是「我刚才一直在重复这个」。thinking-guard 折叠的就是它。
为什么是两个、而且两个都需要
| 插件 | 干什么 | 时机 |
|---|---|---|
thinking-guard | 把退化的思考块从模型可见的历史里折叠掉 | 当场(下一次 pre-step,趁它还没被反复回传) |
dsh-auto-checkpoint | 到水位压缩(清掉累积污染),或换一个新会话 | 事后 |
三条理由,缺一条都会留下漏洞:
- 折叠管不到一次生成内部。 一条复读正在生成的时候它拦不住 —— 只能等下一步再剪。那一步的污染已经产生、已经回传过一次。
- 只有压缩能清"库存"。 多次漏检攒下来的污染块,折叠一块块剪很慢;压缩能一次性把累积的压下去(本机实测:一个会话 12 次压缩,凡有累积污染时压缩后都下降,最强一次 43 → 0,此后零复发)。
- 压缩之间还有步子。 只装压缩的话,两次压缩之间的每一步仍在被污染重放 —— 那正是折叠负责的那一段。
⇒ 一句话:折叠 = 少产生,压缩 = 清库存。两个都在,才是闭环。
💡 两个插件之间有一处联动(2026-10-15 补):
thinking-guard里的急停阀当场掐断复读之后,dsh-auto-checkpoint会顺带压一次 —— 不看水位阈值,也不看那会话在面板上选的处理方式。 阀清的是"正在喷的那一段",压缩清的是"历史累积",接得上。 ⚠️ 这一步要有阀才有(只装dsh-auto-checkpoint的话没有);想关掉只能全局改常量AUTO_COMPACT_ON_VALVE_ABORT(默认true)再重启,详见 auto-checkpoint/README.md。
实测:一个会话跑满 23 亿 token 也没崩
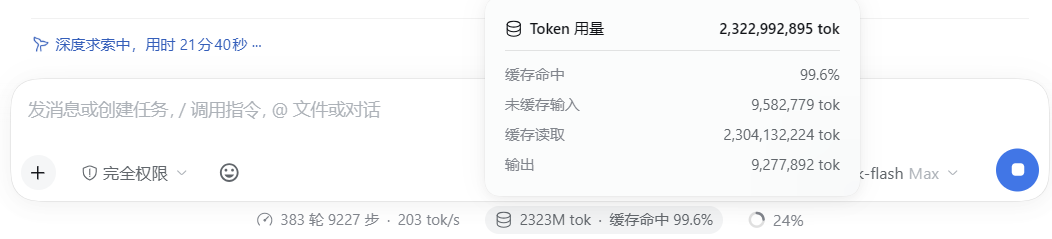
这是一个真实会话的用量面板:383 轮、9,227 步、累计 23.2 亿 token(缓存命中 99.6%), 上下文占用仍然只有 24%。
原因不神秘:dsh-auto-checkpoint 到水位就压缩或换会话,不让历史无限堆积;
thinking-guard 把退化的思考块折叠掉,不让它每一轮重放。
⚠️ 这张图只说明会话没崩,不构成「它比别的方案更快更省」的证明。
装(3 分钟)
→ 看 INSTALL.md(两条命令 + 验证方法 + 常见问题)
它不解决什么(以及配套推荐)
这套件治的是「别崩」:模型陷进复读,或者上下文里堆了污染,它当场掐掉、把库存清掉。 它不治「别失忆」。三件事分开看:
| 你怕丢的 | 压缩会不会弄丢 | 归谁管 |
|---|---|---|
| 人格(说话风格、它是谁) | 不会。人格在系统提示词里,而压缩的范围明确排除系统提示词(dsh-compaction-basic 文档原话:位于 surface 节点 0 的系统提示词永不会被遮蔽) | preset / 模式配置 |
| 任务状态(做到哪、下一步、改了哪些文件) | 不会。压缩前会先落档,新会话读那份检查点接着干 | 本套件(dsh-auto-checkpoint) |
| 会话里谈出来的结论(「我们说好用 A 不用 B」、踩过的坑、你的偏好) | ⚠️ 会。压缩之后模型眼里只剩一份摘要,那些共识不在里面 | ⚠️ 本套件不管 |
第三行才是缺口。本套件保证「会话不崩、任务能接着干」,保证不了「它记得我们之前定过什么」。
要补这一块得另找一个跨会话的长期记忆插件。我们自己在用的是一个第三方开源项目,列在这儿只是供参考:
@aiwayds/dsh-topics-memory:https://github.com/fan56/dsh-topics-memory(MIT)- 不是我们写的,也不由我们维护。它的定位和本套件互补,装法看它自己的 README。
- 它对「记什么」做了很苛刻的取舍,原话是:一个 topic 只记四件事 —— 从什么问题开始、得出了什么结论、 影响什么、依赖什么;至于得出结论的过程(讨论、试错、绕过的弯路)一概不记。
- ⚠️ 它的「语义检索」需要一个本地 embedding 服务(只支持 ollama,默认
127.0.0.1:11434)—— 远程 embedding 被它明确挡在热路径外。没装 ollama 时它自动退回词法检索,这是明确降级、不是故障。
⚠️ 别把它当成「保人格」的方案 —— 人格靠的是模式配置(比如把人格写进 preset 的 persona 行), 记忆插件负责的是「结论级」的跨会话记忆。两件事,别混。
另一个常被混淆的痛点:嫌 token 花钱(而不是嫌上下文长)
这是另一回事:上下文长是「贵在每轮都要重发」,而「要不要为 token 付钱」是单价问题。
我们自己在用的是 dsh-our-free-model(https://github.com/Ebony-Vinyl/dsh-our-free-model,MIT)——
装上不用填 Key,就能用一批前沿模型。
🛑 四条免责,请逐条看完再决定:
- 不是我们写的、也不由我们维护。 列在这里只因为我们自己天天在用。它是个成熟的公开项目(约 1.9 万 star), 有问题请去它自己的仓库提,别提到我们这儿。
- 它治「单价」,完全不治「上下文长度」:记忆插件的注入照占窗口、照拖慢每一轮。
要省上下文,得调记忆插件自己的注入档位(
topK、注入预算、用pointer形态而不是digest)。 - 你的请求发往它自己的上游(目前是 OpenCode 的 Zen 网关,
https://opencode.ai/zen/v1/*,不经第三方中转)—— 不是本地推理。对代码或对话内容出机器敏感的话,先想清楚再装。 - 免费额度能持续多久,不由我们也不由你决定:上游改规则、限速、下架模型,随时可能发生。 别把依赖建在它上面。
两个插件各自
| 插件 | 规模 | README |
|---|---|---|
thinking-guard/ | 约 760 行(lib/ 三个文件,含急停阀),零宿主服务依赖 | 中文|English |
auto-checkpoint/ | 4,292 行,8 个宿主服务 | 中文|English |
阈值推荐(dsh-auto-checkpoint)
| 你的窗口 | 任务边界 | 落档 / 换会话 |
|---|---|---|
| 256K(DSH 默认) | 150k | 180k |
| ≥512K | 250k | 350k |
| ≥1M | 350k | 350k–500k |
350k 是我们自己长期在跑的值,不是比例 —— 512K 和 1M 用同一组数,窗口再大也别乘上去。
⚠️ 这里是一个取舍,按你更怕哪个来挑:
- 怕退化(复读) → 靠 350k 这边。上下文越长,单轮越贵越慢,模型陷进复读的风险也越高。
- 怕压缩太勤 → 可以放到 500k。每次压缩都是一次全上下文请求,还会打散 prompt 缓存,
对高频长任务可能反而更费。
350k–500k是经验值(我们自己的使用体感), 不是实测出来的分界线 —— 我们没在 500k 上长期跑过,也没有「压缩频率 vs token 花费」的对照数据。
怎么调阈值(不用重启)
面板有两个入口,看到哪个用哪个,改的是同一份配置:
- 装了桌宠插件
dsh-cost-whale—— 面板就在桌宠的菜单里,点开就是滑块; - 没装桌宠也没关系 —— 本插件自带一个右下角浮动面板,默认收成一个小按钮,点一下展开: 三个滑块、「干完这些就换新会话」勾选框、模式下拉都在里面。
浮动面板没自动冒出来的话,在地址后面加 ?acfloat=1 强制打开,例如 http://127.0.0.1:3081/?acfloat=1。
(地址里已经带着 ?token=... 这类参数时别再加问号,直接在最末尾加 #acfloat 就行。)
拖动滑块是运行时生效的(面板往运行时接口发一次 POST,内存和磁盘同时更新),不用重启;
只有改包里 cordis.patch.yml 的那些键才需要重启。
状态
- AS-IS,MIT。
- 验证过的版本:DSH 0.2.1-rc.2(真跑过整轮)。0.2.0-rc.2 只核对过源码、没真跑过——两个版本的
dsh-llm都含同一条developer过滤逻辑,所以折叠说明一律走user/message,不依赖版本。两个插件都用了 DSH 的内部服务与内部事件,大版本升级可能一起失效。 - 没在规模化真实环境里验证过;欢迎 fork / PR。
为什么折叠说明是 role: "user"
折叠后留下的那条说明走的是 user/message,不是 developer/message。这是踩过坑之后的选择。
developer/message 转上游本来是 role: "system",语义更对。但宿主在 dsh-llm 的 projectToolUpdates() 里会把不在工具更新名单里的 developer 消息静默丢弃(if (!updateIds.has(message.id)) continue)。实测:会话日志里折叠事件完全正确、deriveMessages() 也返回 developer,可真实 HTTP 请求体里一条都没有——查了三处探针、抓了代理包才定位到这一行。
user/message 是唯一能真正送达的通道。代价是模型可能把它误当成"用户说的话",所以文案做了两件事:首句自报身份(⟪thinking-guard⟫),以及一个祈使句都没有("请…""不要…""直接…"这类句子是"用户下了个命令"的强信号,正是它会让模型开始编造用户说过的话)。
Comments
Loading…
Similar plugins
by MrWeiCodes
为 DeepSeek Harness(DSH)提供的思考循环守护插件:模型陷入「只想不做」的退化循环时自动打断,不必再手动中止
★ 25
↓ 36/wk
MIT
JavaScript
Oct 9, 2026
dsh plugin --profile agent add dsh-loop-guardby yingjian666
DeepSeek Harness (dsh) 插件:注入系统提示词,强制 Agent 的思维链 / 规划 / 工具推理全程使用简体中文,防止中文思考漂移为英文。零外部依赖,任意本地目录 link 即装。
★ 12
MIT
JavaScript
Oct 1, 2026
dsh plugin --profile web add dsh-zh-thinkingby rezon-aki
上下文压缩沿用会话思考档位:DeepSeek 前缀缓存按档位分桶,不修就会在每次压缩时把整个上下文按未缓存价重算一遍。零依赖、不碰官方插件。
★ 0
MIT
JavaScript
Sep 29, 2026
dsh plugin --profile web add dsh-compaction-effort-inheritby lpf20200901
给 AI 编码助手的跨会话长期记忆:自动注入、只推变化。DSH 插件 + 零依赖 CLI。
★ 0
MIT
JavaScript
Oct 15, 2026
dsh plugin --profile web add dsh-memory-deltaby zxmqq1234
DeepSeek Harness(dsh)自动重试插件:报错自动重试、中断自动继续、挂起自动唤醒、 每一步右上角弹窗告诉你,不用再手动发"继续",数据看板还原每一次重试的真相。与 dsh系统重试互补而非替代——在内置重试耗尽或不覆盖的错误码上追加保障。
★ 10
MIT
TypeScript
Oct 15, 2026
dsh plugin --profile web add dsh-auto-retryby lxchapu
DSH(DeepSeek Harness)插件:把会话从磁盘上彻底删除。任意会话的「…」菜单里可删单条,侧边栏切到「仅显示已归档」时可一键删除全部已归档会话;两者都先弹二次确认,正在运行的会话会被拒绝删除。
★ 1
MIT
JavaScript
Oct 3, 2026
dsh plugin --profile web add @lxchapu/dsh-session-purge