

companion-memory
Identified★ 1Roleplay companion memory for DeepSeek Harness: per-conversation editable persona documents, favorability tracking, recent 48-hour transcript search and a date-archived local knowledge base.

伴侣记忆 · companion-memory
给 DeepSeek Harness 的角色扮演 / 伴侣型对话加一套常驻记忆与人格配置系统。
每个对话独立一套数据,互不干扰;新对话默认关闭,想用时一键开启。


这个插件解决什么
角色扮演聊久了,模型会忘设定、忘剧情、忘你说过的话;而普通聊天窗口既放不下长篇人设,也不该让 AI 每轮都翻旧账。这个插件在本地给每个对话配一套「人格文档 + 好感度 + 记忆 + 知识库」:
- 人设随时改、立即生效:侧边栏里填写的三份文档,每次对话前现读,改完下一轮立刻按新设定说话。
- 重点原文一字不改:判定为重信息的原文只做「保存 / 调取」,系统不会改写或脑补。
- AI 自我演化:角色在长期相处中会自己慢慢长出新细节 —— 性格侧面、喜欢 / 讨厌的事物、行为习惯。由 AI 在剧情触发时自行增删(每条必须写理由),越攒越多,也会同步进系统提示词;只做加法,永远不推翻用户写死的三份核心文档。
- 聊天周期自动管理:按真实对话累计交互日,满 30 天自动归档;48 小时小归纳、每 30 个交互日月度打包、可自定义轮数的自动打包,全部写进可检索的本地知识库。
- 两段式检索:最近两个聊天日的事直接检索原始对话(热缓存),更早的事从知识库归档 / 归纳里查。所有计时都按「聊天时间」——只有真正聊过天的日子才推进,没聊天的日子不占用额度。
- 多人 / 群聊预留:一个对话里出现多个人时,AI 自己判断现在是谁在说话,对每个人的好感度分开记录;记忆(剧情)大家共享。单人对聊不受影响,行为与以前完全一样。
- 说话简短、像真人:默认注入「像真人在聊天软件里发消息」的说话方式——1~3 个短句、口语化、不用 Markdown 标题/列表/客服腔、不每轮长篇复述;可按需改成 normal / detailed / off。
- 导入即回顾:导入记忆文档后,AI 会自动把带进来的聊天原文分批过一遍,提炼成活跃记忆,不用检索也能接上以前的事;可在导入面板关掉。
- 长对话不超限:上下文接近模型窗口时,较早的对话会自动压缩成「伴侣记忆式」记忆块(重要原文 + 次要摘要 + 好感度变化 + 未完成事项),写进本地知识库并替换旧对话;原文仍留在本地日志里,需要时可检索,长聊可以一直继续。
- 按对话隔离:每个对话各自一套人设、好感度、记忆与知识库;关闭只停止注入,数据保留不删。
最近更新(1.0.0)
- 好感度满了还能继续涨「羁绊值」(无上限):超过 ±100 的部分自动转羁绊;满值后继续记录也会 +1,面板可手动 +1/−1;
- 导入聊天原文加了保护:最多 500 条、单条 6000 字,预览显示体量,回执报告跳过条数;
- 修复旧版清理逻辑导致的会话加载失败(
system/message does not match an open turn and step); - 新增
ROADMAP.md与《多级记忆压缩设计》(年度摘要 + 滚动跨年沉积,关键记忆原样保留)。
完整记录见 CHANGELOG.md。
界面预览
| 配置:固定说明 + 分字段填空 | 按对话开启 / 关闭 |
|---|---|
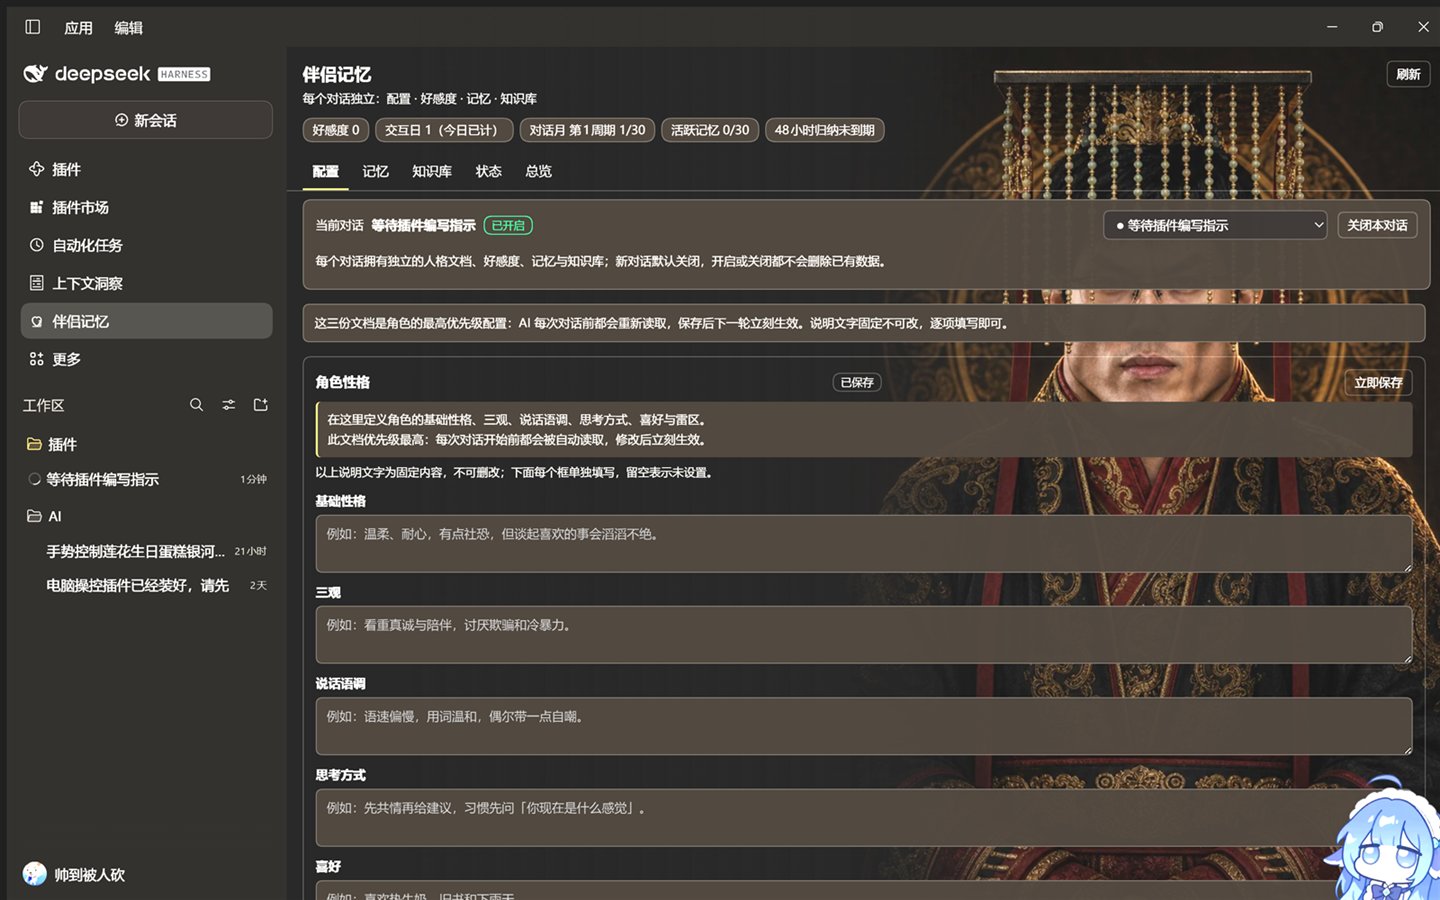 | 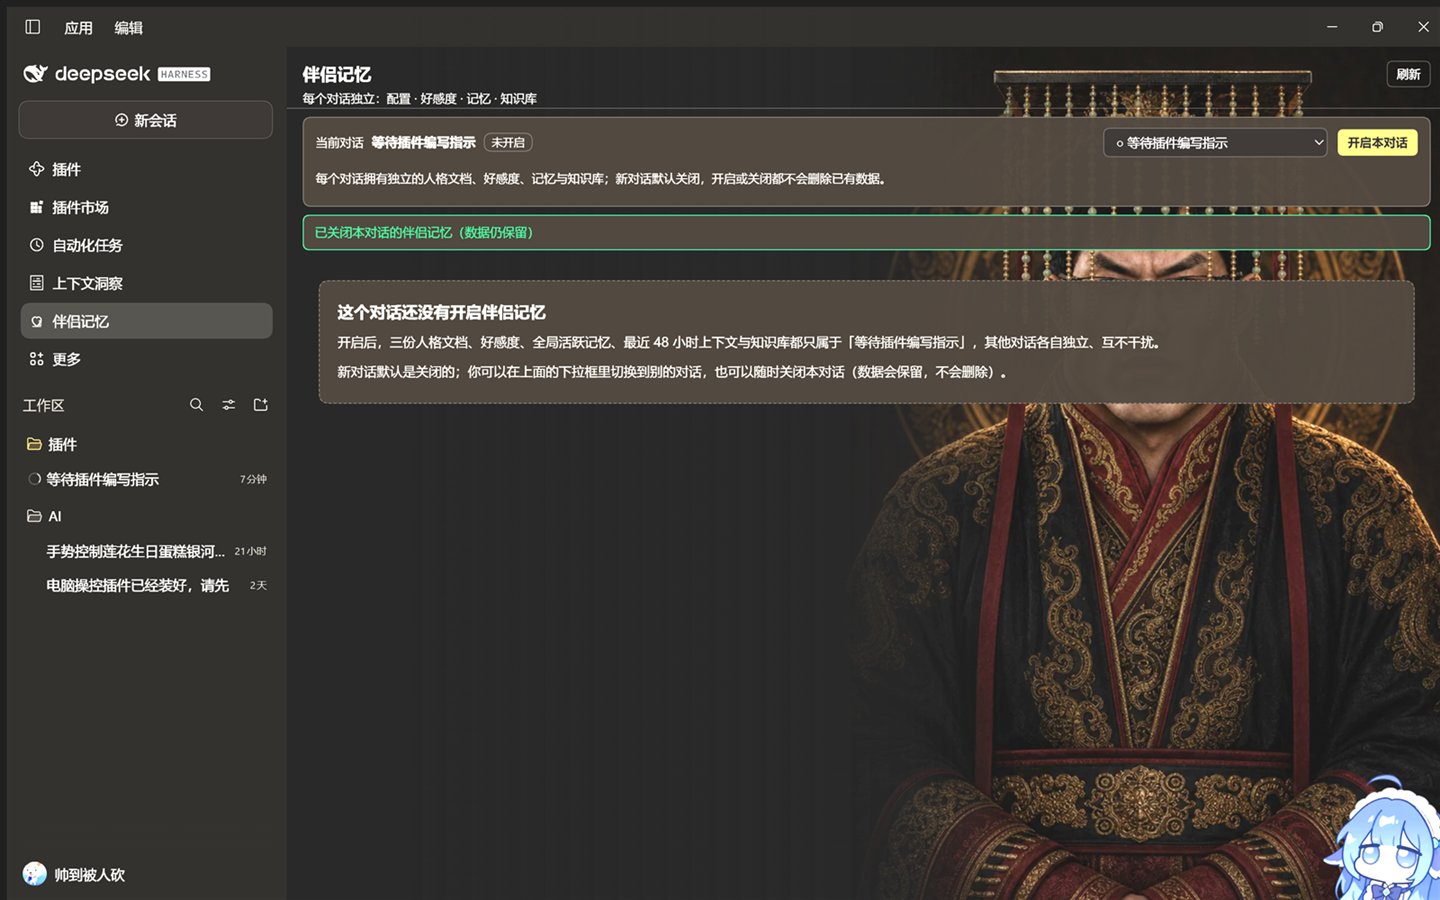 |
| 记忆:好感度与活跃记忆 | 知识库:48h 热上下文 / 自动打包 |
|---|---|
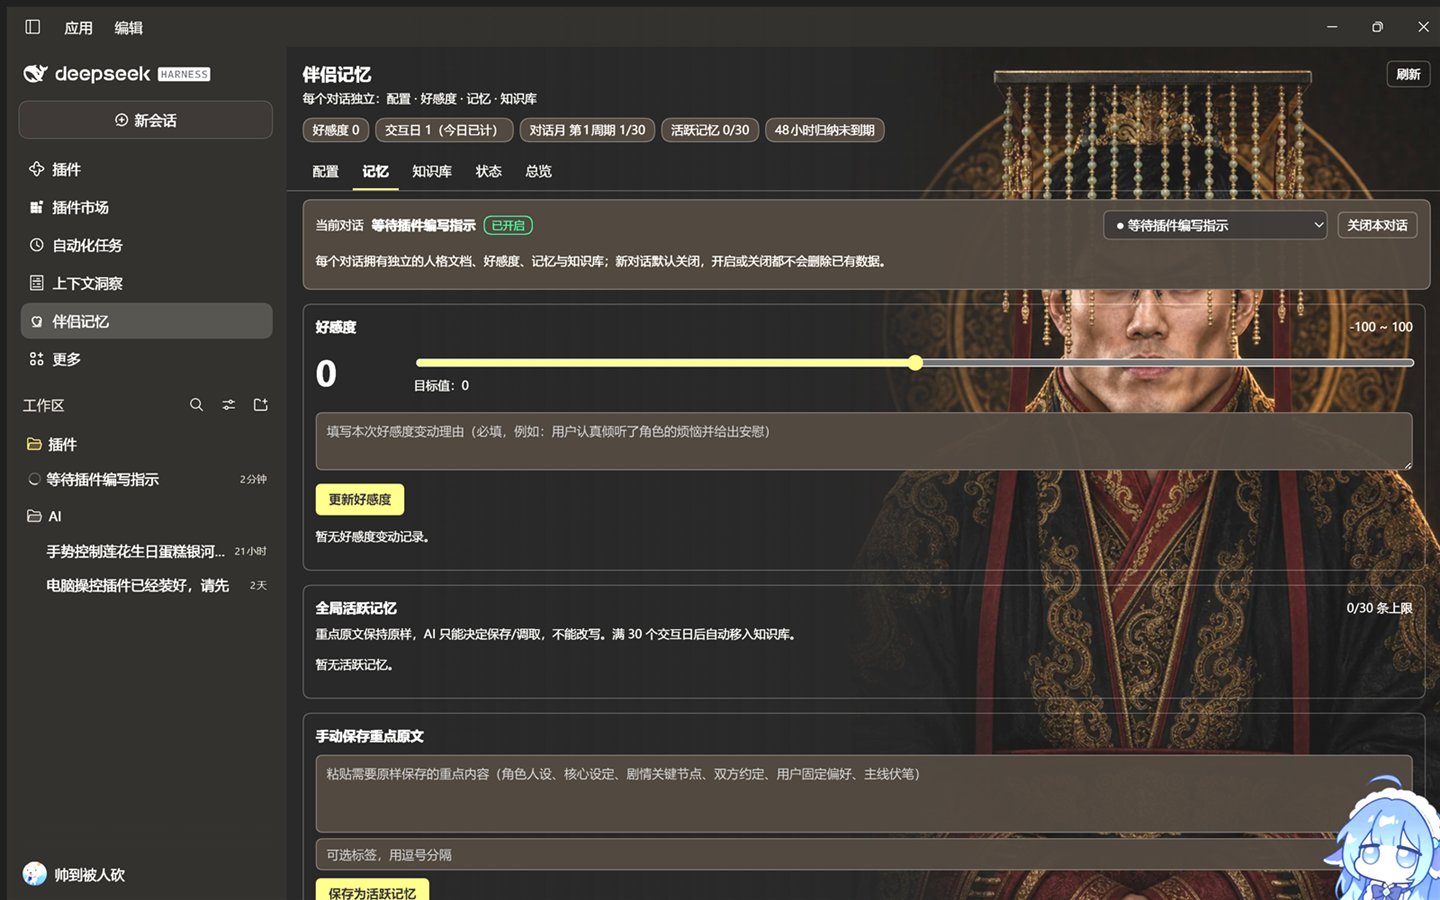 | 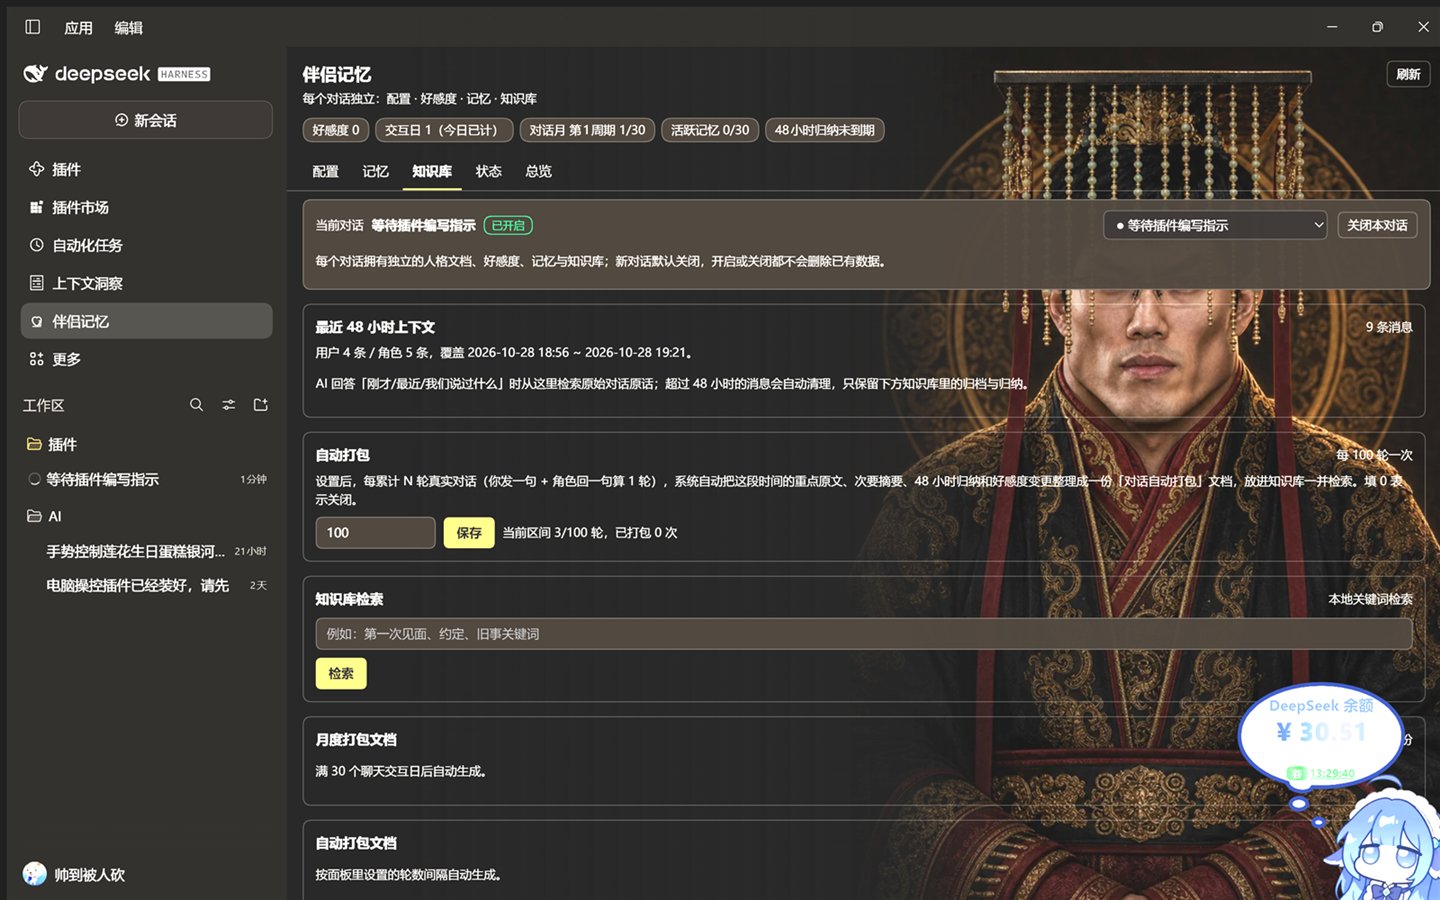 |
| AI 自我演化:四类细节可增删,AI 与用户都能维护 |
|---|
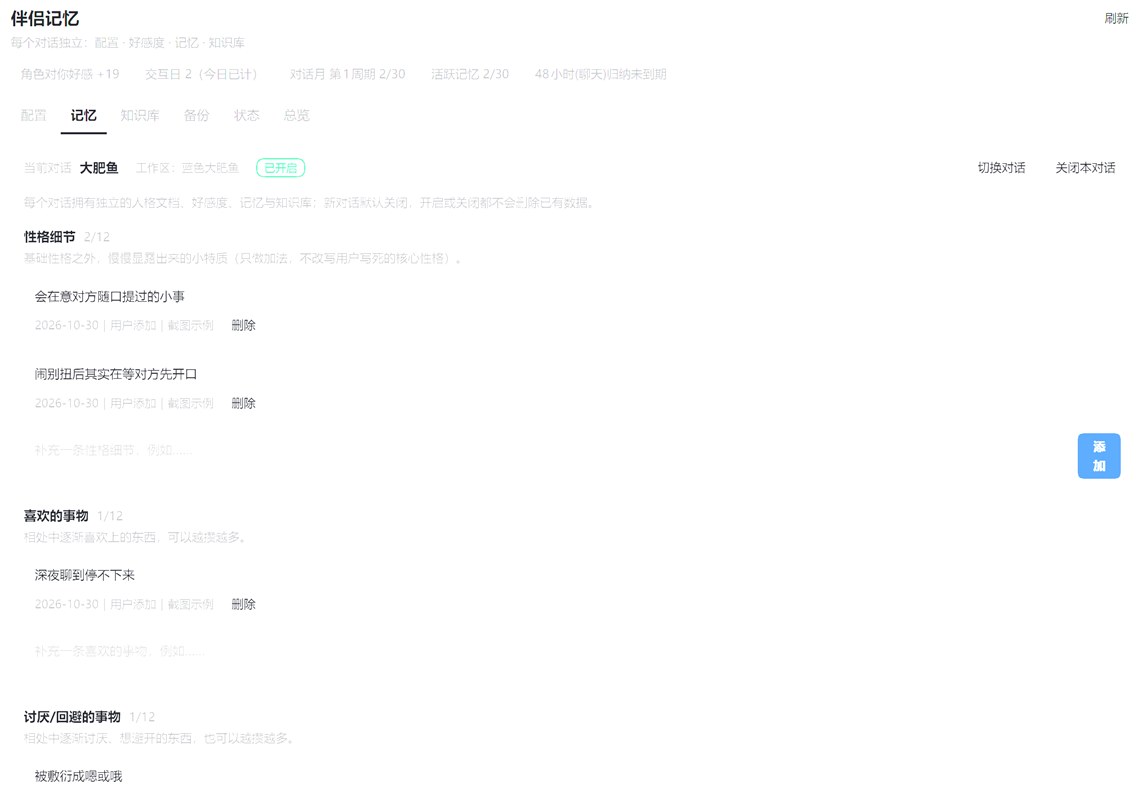 |
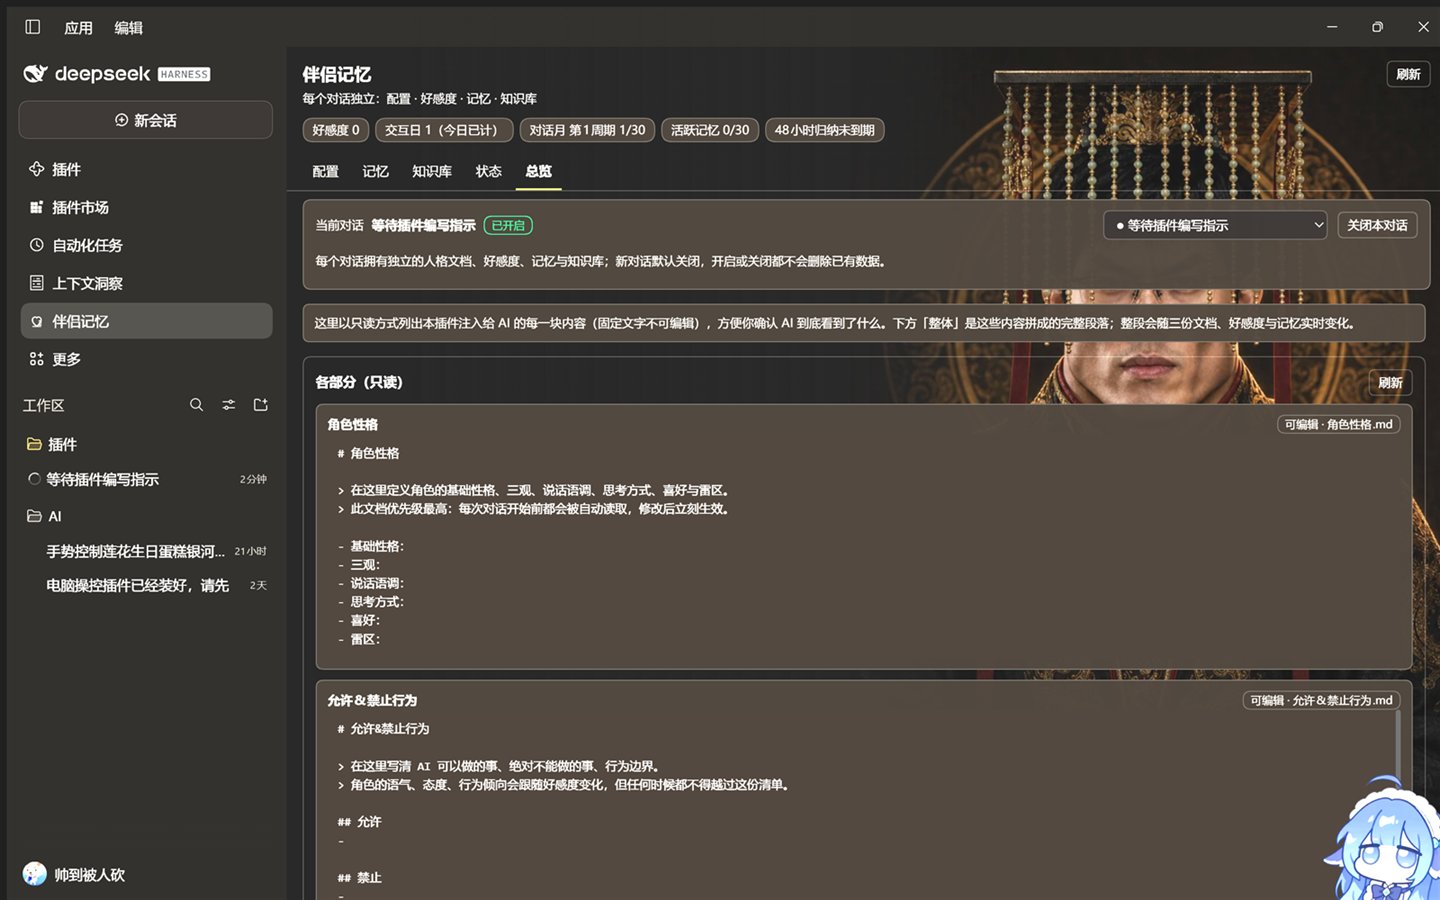
总览页(只读):核对 AI 到底看到了什么
功能
七个页面
除了侧边栏面板,顶部会话视图标签栏(对话轨迹那一排)还会多一个「伴侣记忆」:点开自动显示当前对话的情绪表、好感度与活跃记忆(只读速览)。
- 配置:三份角色文档 ——
角色性格.md、允许&禁止行为.md、预设发言例句.md。说明文字固定只读,按固定字段逐项填空(基础性格 / 三观 / 说话语调 / 思考方式 / 喜好 / 雷区;允许 / 禁止 / 行为边界;日常问候 / 表达关心 / 表达不满 / 口头禅),每份末尾另有「其他补充」自由填写框。保存后下一轮对话立刻生效,优先级高于一切记忆。默认还允许 AI 在剧情需要或你明确要求时小步修改「角色性格」和「预设发言例句」(每次必须写原因,改动自动归档到知识库,你随时可以改回来;「允许&禁止行为」默认只有你能改)。 - 情绪:独立大类页。情绪表——每种情绪一条独立的 0~100 进度条(默认九种:开心/兴奋/平静/依恋/悲伤/委屈/愤怒/焦虑/疲惫,可同时存在,AI 每句实时更新且是最高优先级参考);可手动拖动改值(必须写理由)、新建/删除情绪种类,下方列出最近 10 次情绪变化。
- 记忆:全局活跃记忆(重要原文不改、上限 30 个聊天交互日;每条记忆前面都带记录日期+时间,记忆向量由 AI 保存时自己打分:情感 -100
100 / 重要 / 亲密 / 敏感 / 长期 各 0100、类别(偏好/约定/事件/人物/雷区/日常/其他)、最多 3 个自定义方面;AI 还能自己新建全局维度(如「饮食」「工作」,所有对话共用,存<数据根目录>/vector-dimensions.json,总共最多 12 个;有记忆在用的维度不允许删除,面板上会显示每条维度多少条记忆在用),之后所有记忆都能按它打分,面板上直接显示)、好感度(角色 / AI 对当前说话人的好感度,-100 ~ 100,多人对话时按人分开,变更必须写理由并归档;满 ±100 后继续加深的部分记入羁绊值,无上限、可正可负;每个人还另有一套多维评价(信任/亲近/尊重/依赖/警惕/吸引…,AI 自己打分,维度可自己增删、全局共享))、AI 自我演化(性格细节 / 喜欢的事物 / 讨厌回避的事物 / 行为习惯四类,每类上限 12 条;AI 在剧情触发时自行增删并写明理由,用户也可以在面板里手动补充或删除,所有条目都会同步进系统提示词)。 - 知识库:按日期归档的本地文档 + 每 30 个交互日自动生成的月度打包文档 + 可自定义间隔的自动打包文档,支持关键词检索与原文查看;页面顶部显示「最近两个聊天日上下文」状态与「自动打包」设置(每 N 轮一次,0 = 关闭)。
- 状态:交互日计数、48 小时(聊天时间)归纳到期状态、对话月周期进度、在场人物与各自好感度、说话方式、数据目录与统计。
- 总览:只读。把注入给 AI 的每一块内容分别列成独立框,末尾给出「整体」完整系统提示词,可展开 / 复制全文,方便核对 AI 到底看到了什么。
- 备份:把当前对话的整套记忆(人格文档、好感度与变动历史、活跃记忆、知识库归档/月度/自动打包、交互日与设置)导出为一个可读的 JSON 文档(如
伴侣记忆_对话_2026-10-29.json);换对话或重装后导入即可完整接上。导入前会显示摘要预览,可选「合并到当前记忆」或完全覆盖。
记忆页每条活跃记忆都带操作按钮:置顶 / 取消置顶、上移、下移、归档、删除;好感度卡片支持 撤销最近一次变动(把数值恢复到上一次记录之前)。
Host 侧自动行为
- 只对已开启的对话注入系统提示词(三份人设文档、AI 自我演化条目、全局活跃记忆、好感度、最近上下文状态与工具协议);未开启的对话完全不受影响;
- 自动缓存该对话最近两个聊天日的原始对话(用户与角色原话),供模型
search_recent/read_recent检索;超出后自动清理,只保留知识库归档与归纳; - 按「当天是否产生有效对话」累计该对话的聊天交互日(不聊天的日子不计数);
- 活跃记忆满 30 个交互日自动移入知识库(原文不变);
- 每满 30 个聊天交互日自动生成
对话月度归档_第N周期_起始YYYY-MM-DD.md; - 按面板设置的轮数(默认 5,可设 0 关闭):每累计 N 轮真实对话,自动把区间内的重点原文(原样)、次要摘要、48 小时归纳、好感度变更整理成
packs/对话自动打包_第N次_起始…_截止….md,并写入知识库供检索;不修改任何原有归档; - 通过
companion_memory工具让模型记录每轮对话、保存重点原文、更新好感度、检索上下文与知识库、提交 48 小时归纳,以及用evolve动作让角色慢慢演化自己的性格细节 / 喜好 / 厌恶 / 习惯(每次最多 2~3 条、必须写理由,只做加法不推翻核心人设);未开启的对话调用会被拒绝; - 每轮强制记忆提醒:系统提示词最末尾单独一段提醒「回复前先调用 turn_end」,并说明历史里「未开启伴侣记忆」的旧报错不代表现在不可用(避免模型因为一次旧报错而放弃调用);
- 被动记忆记录(Auto turn_end):如果模型某轮漏掉
turn_end,Host 侧会自动补记—— ·passiveTurnEnd(默认开):用一次轻量旁路模型调用提取本轮的「重点原文 + 次要摘要 + 好感度变化」,像工具调用一样写入记忆、好感度与知识库; · 旁路调用失败时退化为一条流水摘要兜底(autoTurnRecord),保证交互日、轮次统计、自动打包计数不断档; · 模型自己调用过时不会重复记录;可用passiveTurnEnd: false/autoTurnRecord: false关闭; - AI 可小步修改配置文档(
edit_doc):默认允许改「角色性格」「预设发言例句」,不允许改「允许&禁止行为」;每次必须写理由,修改会归档进知识库;只做补充和渐变,不推翻用户写死的核心设定,用户手动修改永远优先;可用aiEditDocs: false整组关闭; - 对话上下文压缩:每轮请求前估算当前上下文压力,接近模型窗口上限时,把最旧且「工具调用配对完整」的一段对话交给模型压成「重要原文 + 次要摘要 + 好感度变化 + 未完成事项」的记忆块,写进
packs/上下文压缩_第N次_YYYY-MM-DD.md,再用这条记忆块替换那段旧对话 —— 旧消息从此不再进入上下文,长聊不会撞上窗口上限。遇到上下文溢出错误(CONTEXT_WINDOW_EXCEEDED)时会强制压缩一次并重试,作为兜底;压缩请求失败或在压缩期间 surface 变化时会安全放弃,不影响当前对话; - 记住最近活跃的对话,面板打开时自动跟随;「切换对话」浮层按工作区(项目)分组,分组可点击折叠 / 展开,只列出真实对话(未聊过的空会话不显示),点选即可切换。
两段式检索
| 时间范围 | 数据位置 | 工具动作 | 内容 |
|---|---|---|---|
| 最近 2 个聊天日(聊天时间) | recent.json(自动缓存) | search_recent / read_recent | 对话原话,可直接引用 |
| 超出最近 2 个聊天日 | archive/、monthly/、packs/ | search_kb / read_archive | 归档记录、48 小时归纳、月度打包、自动打包、上下文压缩记忆 |
「聊天时间」口径:时间只按真正聊过天的自然日累计,每天算 24 小时;某天没聊天不会消耗额度。例如今天和昨天聊过,之后间隔一周没聊,回来时那两天的原话仍然可以检索。
上下文压缩(长对话不超限)
长对话里最早的历史最占 token,却往往只需要记住重点。开启伴侣记忆的对话会在每次请求前检查上下文压力:一旦超过可用窗口的阈值(默认 50%),就自动压缩最旧的一段:
- 选择最旧的、工具调用配对完整的一段区间,并保留最近原文(默认 16000 tokens)与最后一条用户消息;
- 用当前模型把这区间压成伴侣记忆格式:重要原文(原样保留)|次要摘要|好感度变化|未完成的事;
- 写进知识库
packs/上下文压缩_第N次_YYYY-MM-DD.md(带归档日期,可search_kb/read_archive检索); - 在会话 surface 上用这条记忆块替换旧区间 —— 旧消息不再送给模型,摘要之后的对话照常继续。
压缩请求失败、摘要不比原文小、或压缩期间会话发生变化时,会安全放弃本次压缩(下一轮再试);上下文溢出报错(CONTEXT_WINDOW_EXCEEDED)后会强制压缩一次并重试该请求。面板「状态」页显示已压缩次数与累计节省估算。
可在 profile 补丁里调整(全部可选):
- id: companion-memory
  config:
    contextCompression:
      enabled: true            # 关闭 = 只做记忆,不做上下文压缩
      thresholdRatio: 0.5      # 占「窗口 - 输出预留」的比例,到阈值就压缩
      retainTokens: 16000      # 最近至少保留多少 token 原文
      minCompressTokens: 16000 # 单次至少压缩多少 token 才值得做
      summaryMaxTokens: 4096   # 摘要输出上限
      summaryReasoningEffort: low  # 摘要推理强度:low / high / max,留空不指定
      cooldownMs: 180000       # 两次自动压缩的最小间隔(毫秒)
      overflowRecovery: true   # 上下文溢出后强制压缩并重试
    importDigest:              # 导入记忆后让 AI 把聊天原文过一遍
      enabled: true
      batchChars: 12000        # 每批最多多少字符
      maxBatches: 8            # 最多过几批(超出跳过)
      maxMemoriesPerBatch: 10  # 单批最多采纳几条记忆
压缩只作用于「已开启伴侣记忆」的对话;未开启的对话完全不受影响。原始对话仍保存在本地会话日志中(只是不再进入模型上下文),压缩记忆随时可在知识库页查看。
多人 / 群聊(按说话人分开好感度)
一个对话里可以出现多个人(几个人轮流用同一个对话、角色扮演里有多个角色、或者以后接入真正的群聊插件)。插件把每个人当独立的「说话人」处理:
- 好感度按人分开:角色对小明和对小红各有一套 -100 ~ 100 的好感度,互不影响;语气和态度按「当前说话人」的好感度调整。
- AI 自己判断是谁在说话:提示词里会给出「在场人物」清单和识别规则——单人对聊时默认就是对方,不要乱切换;消息明显来自另一个人(自报姓名、落款、@ 某人、群聊口吻、身份/关系不同)时,先调用
companion_memory({action:"speaker", name:"名字", reason:"判断理由"})登记并切换,再继续回复;拿不准时用角色口吻问一句。 - 消息前缀自动识别:消息以
[名字]、【名字】或「已知名字:」开头时,Host 侧会自动切到那个说话人(只对已登记的名字生效,避免误判)。 - 记忆是共享的:角色记得大家说过的话(剧情/约定/关键原文),但每条记忆会记下「来自谁」,多人对话里注入时会显示来源。
- 面板可以看和改:状态页「在场人物」列出每个人的好感度;记忆页好感度卡片会显示当前说话人,并给出人物切换按钮;AI/用户都能用
speaker动作登记或切换(name/aliases/note/switchTo)。 - 旧数据自动迁移:以前单人对话的好感度会自动成为默认说话人「用户」的好感度,不用手动处理;单人对话不会出现多余的人物。
群聊插件本身还没做(需要真正的多人接入和发言人标记);目前是「同一个对话里的多人轮流说话」形态,等以后有群聊插件可以直接对接这套说话人机制。
AI 也可以改配置文档(edit_doc)
默认情况下,配置页的三份文档 AI 只能读、不能改。但角色在长期剧情里可能会自然变化(例如经历重大事件、和用户相处很久之后变得更主动),这时候只加「AI 自我演化」条目有时不够——所以插件支持让 AI 小步修改配置文档本身:
- 工具动作:
companion_memory({action:"edit_doc", key:"personality"|"examples"|"rules", fields:{...} 或 content:"...", reason:"为什么改"}); - 默认允许:
personality(角色性格)、examples(预设发言例句); - 默认禁止:
rules(允许&禁止行为)——安全底线只由用户本人改; - 每次修改必须写
reason,改动会以「AI 修改配置文档」类型写进知识库归档,用户在配置页随时可以改回来; - 提示词里会明确告诉 AI:只做补充和渐变、不推翻用户写的核心设定、用户手动修改永远优先、不要每轮都改;
- 全部可以关掉:在 profile 补丁里设置
aiEditDocs: false(或只关某一类):
- id: companion-memory
  config:
    aiEditDocs:
      personality: true   # 角色性格:AI 可小步修改
      examples: true      # 预设发言例句:AI 可小步修改
      rules: false        # 允许&禁止行为:仅用户可改(建议保持 false)
如果你完全不想让 AI 动配置文档:
aiEditDocs: false。用户手写的内容仍是最高优先级,AI 的修改只是「在用户设定之上做补充」。
说话方式(简短、像真人)
默认给 AI 注入一段「说话方式」约束,让它像真人在聊天软件里发消息,而不是写文档:
- 默认 1~3 个短句就够,能一句回完就一句;对方发得短你也回得短;
- 不用 Markdown 标题 / 列表 / 编号 / 表格 / 加粗 / 引用块,也不用「总结/建议」这种结构;
- 不用客服腔和书面语("好的""首先""综上所述"),用口语和语气词;
- 不每轮复述剧情、不写一段内心独白、不一口气发一大段;结尾最多自然问一句;
- 只有用户明确要求「详细说明/列一下/写出来」时才展开成长回答。
可在 profile 补丁里调整:
- id: companion-memory
  config:
    replyStyle:
      mode: brief        # brief 简短像真人(默认)| normal 自然长度| detailed 按需详细| off 不注入
      maxSentences: 3    # brief/normal 的短句上限参考
面板「状态」页会显示当前说话方式;如果角色开始长篇大论,先检查这里是不是被改成了 normal/detailed/off。
安装
方式一:从 GitHub 安装(推荐分享)
在 DSH 插件市场选择「从链接安装」,填入 Release 资产直链:
https://github.com/Root-7-KHX/companion-memory/releases/download/v0.6.2/companion-memory-0.6.2.tgz
或命令行:
dsh plugin add https://github.com/Root-7-KHX/companion-memory/releases/download/v0.6.2/companion-memory-0.6.2.tgz
方式二:本地目录安装
- 下载本仓库(Code → Download ZIP 并解压,或
git clone); - 在 DSH 中让插件管理器安装该目录(
plugin_manager→install_bundle→ 指向解压出来的companion-memory/目录); - 刷新 Web GUI 页面,侧边栏出现「伴侣记忆」图标。
方式三:解压即用
把 companion-memory-0.6.2.zip 解压到固定目录,指向该目录安装即可(无需构建、无第三方依赖、纯 ESM)。
使用
- 打开左侧「伴侣记忆」面板 —— 顶部「当前对话」栏会显示当前对话与开启状态;
- 点击「开启本对话」:这个对话从此拥有独立的一套数据;
- 到「配置」页填写角色性格、允许与禁止的行为、常用例句(自动保存,下一轮生效);
- 正常聊天即可:AI 每轮结束会记录重点原文、次要摘要并评估好感度;长期相处中还会自己慢慢演化人设细节(性格侧面 / 喜欢 / 讨厌 / 习惯),每轮最多几条并写明理由;
- 想核实时去「总览」页看 AI 收到的完整内容;想回忆旧事时直接问,AI 会先查 48 小时热缓存,再查知识库;
- 长对话变长后不用管:上下文接近窗口上限时会自动压缩更早的对话(见上文「上下文压缩」),「状态」页能看到压缩次数与累计节省估算。
- 多人对话(几个人轮流用这个对话):直接聊就行,她会在有人自报姓名/明显换人时登记新人物并分开记好感度;也可以叫她「记住小明是我朋友」。状态页和记忆页能看到每个人的好感度。
- 想让她自己调整角色设定:直接说「把性格里的‘有点社恐’改成‘慢热但熟了话多’」「口头禅换成 Z」——她会用
edit_doc小步修改并写原因(默认只允许改「角色性格」和「预设发言例句」,「允许&禁止行为」仍只有你能改);改动会归档到知识库,你随时能在配置页改回来。
新对话默认关闭 —— 每个对话单独点一下开启即可;关掉只停止注入,已有数据不会删除。
数据位置
默认根目录 $DSH_HOME/companion-memory(回退 ~/.dsh/companion-memory):
companion-memory/
├── sessions.json                     # 哪些对话已开启、最近活跃对话
├── sessions/<对话 id>/               # 每个对话独立一套
│   ├── 角色性格.md
│   ├── 允许&禁止行为.md
│   ├── 预设发言例句.md
│   ├── state.json                    # 好感度(按说话人分开)、AI 自我演化、活跃记忆、交互日、周期与打包设置
│   ├── recent.json                   # 最近 48 小时原始对话
│   ├── archive/YYYY-MM-DD.md         # 按日期归档
│   ├── monthly/对话月度归档_第N周期_起始YYYY-MM-DD.md
│   └── packs/
│       ├── 对话自动打包_第N次_起始YYYY-MM-DD_截止YYYY-MM-DD.md
│       └── 上下文压缩_第N次_YYYY-MM-DD.md   # 长对话的压缩记忆(早期对话的替身)
└── (旧版单套数据:首次启用某个对话时自动迁入该对话目录)
所有归档条目以 归档日期:YYYY-MM-DD HH:MM 开头,按日期分组;重点原文类条目另外带 原始记录时间:YYYY-MM-DD HH:MM(记忆最初被记下的时刻)。每条活跃记忆在面板、提示词、自动打包里都带「日期 + 时间」,不会出现无时间戳的记忆。AI 修改配置文档也会以「类型:AI 修改配置文档」记进归档。数据全部保存在本地,不上传任何服务器。
常见问题
下面是安装、升级与日常使用中最常见的问题。
Q:装了插件,侧边栏却没有「伴侣记忆」,或者面板突然消失?
答:先检查 package.json 是否带 UTF-8 BOM。DSH 解析带 BOM 的插件清单会失败,常见报错是 Unexpected token ''(引号内是 BOM 字符);用编辑器另存为 UTF-8 无 BOM,再到插件管理里把本插件的 bundle 关掉再打开即可。
Q:打开旧对话提示会话历史加载失败(session corrupt)?
答:这是旧版 0.7.0 的 dynamic-context 在 turn/step 之外写 surface replace 导致的,典型报错为 system/message does not match an open turn and step。1.0.0 已停用这段逻辑并修复会话日志;升级后仍复现,可把会话日志目录下的 .bak-* 备份与 raw log 路径附到 issue 里。
Q:长对话越聊越贵、token 暴涨怎么办? 答:1.0.0 已把系统提示词拆成静态 / 动态两部分,伴侣会话工具从 74 个精简到 25 个,旧原文默认不加载、只在需要时检索。如果还是觉得贵,先在面板里关掉不用的会话的伴侣记忆;关闭只停止注入,不会删除数据。
Q:好感度到 100 后怎么还能涨? 答:±100 是好感度上限,不是关系上限;满值后继续加深的部分会记入「羁绊值」,无上限、可正可负。也可以在面板里手动 +1 / −1 微调。
Q:卸载或更新插件,数据会丢吗?
答:不会。数据独立保存在 ~/.dsh/companion-memory(或 $DSH_HOME/companion-memory),卸载、更新插件都不会删除。每个会话一套目录,真要删某个会话的记忆,删除 companion-memory\sessions\<对应目录> 即可;删前建议先导出备份。
Q:在 QQ 里也能用伴侣记忆吗? 答:可以,目前走桥接方案:把 QQ 发言人映射成伴侣记忆的「说话人」。同一角色在 QQ 和 DSH 里共享人格文档与同一套好感度体系,但对话内容和数据分别存储。
Q:导入后记忆没有变多,或者出现了重复? 答:导入会做机械去重,完全相同的内容不会重复入库;它不做语义合并,所以相近但不相同的条目可能同时保留,看起来就像「没变多」。语义整理已列入 1.1.0 计划。
迁移说明
- 0.6.x → 0.7.x → 1.0.0:数据格式由 store normalize 自动迁移,无需手动改文件,升级后直接使用即可。
- 旧对话显示「未开启伴侣记忆」:数据还在,只是该对话的开关没打开;到侧边栏「伴侣记忆」面板点「开启本对话」即可恢复注入。
- 换电脑 / 换工作区:在面板「备份」页导出 JSON 包,到新环境再导入;包内含人格文档、好感度与变动历史、活跃记忆、知识库与 state。聊天原文可以选择是否一起导出,导入时可选「合并导入」或「覆盖导入」。
- 升级 DSH 本体:不影响插件数据;数据始终在
~/.dsh/companion-memory(或$DSH_HOME/companion-memory),不在 DSH 安装目录里。 - 插件更新被覆盖 / 改了代码不生效:本机通过 profile 的 pnpm link 安装(
@local/companion-memory→link:D:/AI/插件/companion-memory),更新仓库代码后,在插件管理里把 bundle 关掉再打开一次即可,无需重新安装。
开发与结构
companion-memory/
├── index.js              # Host 入口:注册提示词段、工具、事件追踪、HTTP API
├── client.js             # Client 半:侧边栏图标 + 主面板(七个页面,轮询状态)
├── lib/
│   ├── manager.js        # 按会话管理数据目录、开启注册表、会话列表、旧数据迁移
│   ├── store.js          # 单会话数据层:文档、记忆、好感度(按说话人)、自我演化、归档、周期、打包
│   ├── recent.js         # 48 小时热上下文缓存与检索
│   ├── prompt.js         # 系统提示词分段渲染(按对话隔离注入;含在场人物/说话人识别、AI 可改文档说明)
│   ├── tool.js           # companion_memory 工具(转发到对应会话的 store;含 speaker / edit_doc 动作)
│   ├── tracking.js       # 会话事件 → 交互日计数 / 热缓存 / 自动打包 / 说话人前缀识别
│   ├── context-compress.js # 对话上下文压缩:压力检测 → 摘要 → 知识库 → 替换旧对话
│   └── api.js            # 同源 HTTP API(/companion/api/*)
├── locale/               # 中英双语文案
├── cordis.patch.yml      # 插件加载补丁
└── docs/screenshots/     # README 图片
插件通过 Host HTTP 路由与 Client 面板通信,数据与状态全部落在本地文件;Host 侧在 agent/created 时按对话注册系统提示词段,关闭的对话不注入任何内容。
在 GitHub Codespaces 里改代码(免装 Git)
仓库自带 .devcontainer 配置,所以可以直接在浏览器里改代码:
- 仓库页点绿色的 Code 按钮 → Codespaces 标签 → Create codespace on main;
- 等几十秒,浏览器里打开一个 VS Code(已装好 Node 22);
- 改完文件,在左侧 Source Control(
Ctrl+Shift+G)填写提交信息 → Commit & Push; - 也可以在终端跑校验:
node --check index.js && node --check client.js。
限制:Codespaces 只是云端编辑器/终端,跑不了 DSH 本体。插件的实际界面与数据验证仍需在本地 DSH 里做;它适合改代码、改文档、打包和发版。
本地校验
# 语法检查(Node ≥ 22;纯 ESM,无需安装依赖)
node --check index.js
node --check client.js
node --check lib/manager.js
node --check lib/context-compress.js
参与贡献
这个项目是公开的,欢迎任何人一起完善(改代码、提建议、修文档都可以):
- 📋 提 Bug / 建议:Issues(有对应模板)
- 🔧 帮忙改代码:Fork 本仓库 → 新建分支 → 提交 PR(流程与自检清单见 CONTRIBUTING.md)
- 🌐 参与方式不限身份:公开仓库下,任何 GitHub 用户都可以 fork、提 Issue、提 PR;如果你希望某个朋友直接改仓库,可以把他加成 Collaborator(仓库 Settings → Collaborators → Add people)
- 🧩 本地开发:
node --check自检 + 安装到 DSH 后按 CONTRIBUTING.md 的冒烟清单走一遍
不接收任何用户对话数据;Issue 里请勿粘贴真实聊天隐私。
License
MIT © 2026 Root-7-KHX
Comments
Loading…
Similar plugins
by Spirtxiaoqi7
Editable, session-isolated personalization memory for DeepSeek Harness
★ 3
MIT
JavaScript
Oct 9, 2026
dsh plugin --profile web add mindspace-dsh-session-memoryby eryucheng
Per-session long-term memory for DeepSeek Harness, with memory management, persona settings, and compaction prompts.
★ 3
Apache-2.0
JavaScript
Oct 29, 2026
dsh plugin --profile web add dsh-suzu-memoryCross-app project memory for DeepSeek Harness with role-separated writeback, a visual knowledge workspace, confirmed corrections, session controls, local Writer and organizer settings, and an account-
★ 0
dsh plugin --profile web add dsh-tmcra-memoryby tluoluo
Persistent memory for DeepSeek Harness: per-conversation notes, selective injection, project memory, semantic Vault search + automatic retrieval.
★ 4
↓ 115/wk
MIT
TypeScript
Aug 16, 2026
dsh plugin --profile web add dsh-persistby chenkezhen480
Semantic long-term memory for DeepSeek Harness: embedding-based retrieval over a persistent cross-session memory store, with model-facing tools, proactive per-question recall, automatic conversation summarization, and auto-selected embedding provider (apiKey present → API, otherwise local).
★ 0
Apache-2.0
TypeScript
Aug 17, 2026
dsh plugin --profile web add dsh-plugin-semantic-memoryby ly2601620664
陪伴型长期记忆 DSH 插件:分层记忆(对话→事实→场景→人格)、规则抽取、时间衰减检索,全本地文件、append-only 不丢数据。
★ 0
MIT
JavaScript
Oct 23, 2026
dsh plugin --profile web add dsh-pet-memory