

dsh-course-assistant
Manifest valid★ 1DeepSeek Harness 插件:课程文件(PPTX/PDF/DOCX/MD)→ 目录识别 · 分章知识点 · B 站网课推荐 · Markdown/PDF 学习报告
课程助手 · 课程文件 → 目录 · 知识点 · B 站网课 · 学习报告
DeepSeek Harness 插件(bundle)。把课程文件拖进面板,自动识别章节目录,逐章生成知识点/重点/难点, 检索 B 站配套网课,最后输出一份 Markdown 学习报告(可导出 PDF),报告末尾固定附 B 站网课列表。
- 完整页面:左侧栏「课程助手」图标(
main槽位,keycourse-assistant) - 常驻入口:输入框下方 dock 的一行「🎓 课程助手 · 打开面板 →」(
conversation.composer.dock) - 给 Agent 的 Tool:
course_assistant(analyze/status/library)
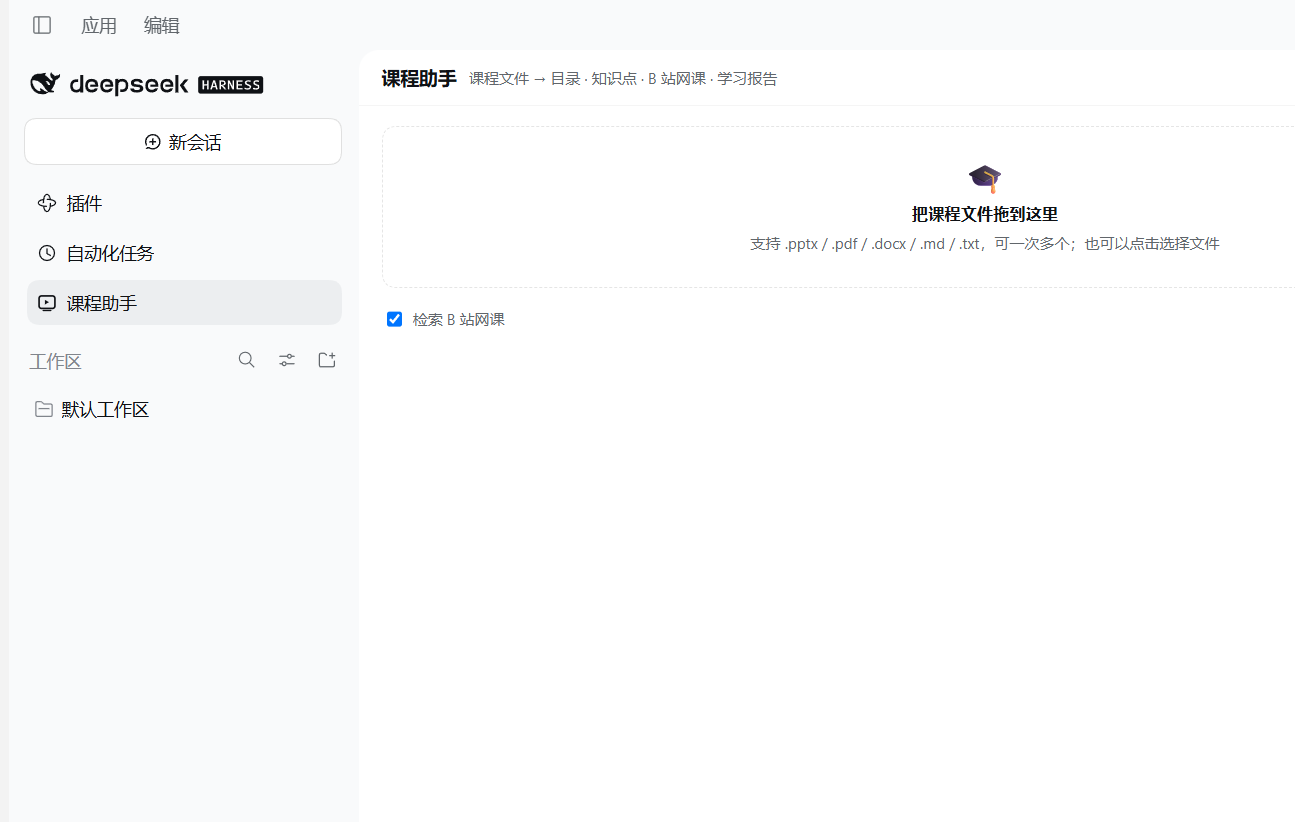
界面
| 区域 | 内容 |
|---|---|
| 拖拽区 | 拖入或点击选择,支持 .pptx .pdf .docx .md .txt,一次最多 12 个(单文件 ≤60MB) |
| 选项 | 「检索 B 站网课」可关闭(关掉后不产生任何站外请求) |
| 进度 | 解析 → 识别目录 → 逐章总结(边出边显示)/ 并行检索 → 生成总结 → 报告 |
| 标签页 | 知识点(每章要点、⭐重点、⚠️难点、关键词)· 目录 · B 站网课 · 报告(渲染 + 下载 MD/PDF/复制) |
报告格式
严格按需求给定的结构:
# 《课程名》学习报告
> 生成时间 / 来源文件 / 章节数 / 总结模型
## 一、课程目录
## 二、各章知识点      ### 第 N 章 …  - 要点 / - ⭐ 重点 / - ⚠️ 难点 / - 关键词
## 三、课程总结        (≤300 字)
## 附录:B 站相关网课推荐
### A. 系列课程推荐    序号 | 标题 | UP 主 | 播放量 | 时长/集数 | 链接
### B. 分章节视频推荐  章节 | 标题 | UP 主 | 播放量 | 时长 | 链接
附录不会为空:检索被风控或没有相关结果时,该行退化为
https://search.bilibili.com/all?keyword=<URL编码关键词> 搜索入口。
1.2.0 新增:读不准时的处理
质量闸门(解析后立即算,纯本地)——四项指标:每页字数、可疑字符率、空页率、成词率。判定 good / fair / unusable,报告头部直接写出来,例如:
文本可读性:不可用(73 字/页,全文 3719 字,空页 18%,可疑字符 9%) ⚠️ 文字层不可用:这份文件里的文字没能被正确提取(多为导出型 PDF 的字形编码)…
面板反馈:报告出来后问「这次结果符合你的预期吗?」,选"不太行"展开三条补救:换源文件(最优)/OCR 重读/关闭网课检索重跑。/rerun 复用原上传文件,不丢输入。
OCR 重读(可选):WinRT 渲染 + Windows OCR(zh-CN),约 1 秒/页,默认上限 60 页。仅 Windows;health.ocr 会用来说明是否可用。
领域锚定:从代码特征识别课程语言(#include/std::/cout → C++;System.out → Java…),然后
- 章节关键词强制带域:「Python 异常处理」→「C++ 异常处理」
- B 站查询加前缀:
C++ 异常处理 - 排序时丢弃跨语言结果(C++ 课不会推 Java 教程),命中本域的加权
识别不准时可在配置里写死:domain: 'C++'。
另外四项小改进:
| 改进 | 效果 |
|---|---|
| 字形反查(借鉴 pdf.js 思路) | 字体缺 /ToUnicode 时,解析嵌入的 TrueType cmap 表并反转成 GID→Unicode,把"字形编号"还原成真字;实测两份 PowerPoint 导出的 PDF:汉字数 0 → 734 / 464,可疑字符 9% → 0% |
| 演讲者备注 | 读 notesSlides,讲义备注往往是完整讲稿;实测 34 页 PPT 多出约 6 400 字 |
| 编码还原 | 无 ToUnicode 的字体先按 GBK/Big5 再解一次,能救"GBK 字节被当 Latin-1"的老 PDF |
| 同名源文件择优 | 同时拖 x.pptx 与 x.pdf 时自动用 pptx,并提示跳过了哪个 |
| 要点重合计分 | 每章要点与原文算 bigram 重合度,低于 30% 标「可能有推断成分」 |
1.5.0 新增:B 站推荐不再跑题
问题来自真实课件(第2章_数据的机器级表示和处理.pptx):第 3 章「四、编码方案」推荐了
中职英语、ESP32 蓝牙、阅读理解答题框架。根因是用页标题当搜索词(「主要内容」)、
课程没有主题锚词(domain 只认编程语言)、以及排序里热度权重过大。
五层修复:
- 清洗输入(
core/terms.js):GENERIC_TERMS拦截「主要内容/本章小结/思考题…」,cleanTerm()去掉「四、」「3.」「第 X 章」等编号,清洗后不足 2 个汉字直接丢弃; 模型不可用时,兜底关键词改用 TF-IDF 从本章正文抽取,而不是抄页标题。 - 课程主题档案(
core/topic.js):anchor优先取配置 domain,其次各章关键词首词投票 (本例 3 章都以「计算机系统」开头 → anchor 立即可得),再退回课程标题;vocab是全文 TF-IDF 前 40 术语;negative是常见学科词减去课程全文出现过的 (真正的英语课不会被误伤)。 - 逐级放宽搜索:
L1 锚词+概念→L2 两个概念→L3 课程主题→L4 只给搜索链接, 上一级不足 2 条才放宽;概念按长度升序取(「补码」比「数据的机器级表示」更窄)。 - 主题过滤(
judgeVideo):候选必须「命中锚词 或 ≥2 个 vocab 术语」且「命中 ≥1 个概念词」 且不命中 negative;否则直接淘汰——把原来只针对编程语言的conflictsDomain推广到所有课程。 - 两段式排序:
relevance ≥ 0.5才计分,score = 0.75×relevance + 0.15×热度 + 0.1×合集, 不对题的视频播放量再高也是 0。
同时修了章名:informativeTitle() 遇到通用词章名会依次改用「第一个有信息量的小标题」→
「正文首行」→「TF-IDF 前两词」,目录里不会再出现「主要内容」。
实测(同一份课件,改前 → 改后):
| 改前 | 改后 | |
|---|---|---|
| 第 3 章推荐 | 中职英语 / ESP32 蓝牙 / 阅读理解(0.627/0.627/0.606) | 深入理解计算机系统[00] 无符号整数、二进制补码(0.876, rel 1.0)等 |
| 跑题词命中 | 3 条 | 0 条 |
| 有推荐视频的章 | 5/5(但多数跑题) | 4/5(「码点空间」这类冷门词给搜索链接) |
| 章名 | 第 1、5 章都叫「主要内容」 | 改成「一、计算机系统层次中的编码任务」「2.3. 字符数据的机内表示」 |
1.4.0 新增:有依据的要点、可续跑的流程、可校验的配置
每条要点必须带原文引文,并由本地核对(core/verify.js)——模型不再"自评可信度",而是给出
evidence(原文连续片段),插件把它和章节原文做归一化(NFKC / 去空白标点 / 全半角)后比对:
| 判定 | 含义 |
|---|---|
exact | 引文是原文子串 |
fuzzy | 4-gram 覆盖率 ≥ 0.85(标点/空格被改写的引文) |
short | 归一化后不足 10 字,算不了一次有效核对 |
missing | 找不到 |
由 evaluateSummary() 收敛成三档 verified / weak / suspect + 原因码;报告、面板、warnings
读同一个对象,文案只陈述测量值("词面重合 34%:要点多为改写"、"5 条引文 2 条找不到"),
不再用词面重合度推断"编造"。空原文的 supportScore 从原来的 1 改为 null(没有原文不该满分)。
manifest + 重启可重跑:每个 job 落盘 inputs(相对路径 + sha256 + uploadId)、
outline.boundaries(分章边界 + hash)、ocr(引擎/页数)与 schemaVersion。
重启后 /rerun 从 manifest 恢复输入,按锁定的边界取原文——改分章算法不会给旧任务重新编号。
OCR 结果按内容哈希缓存(<dataDir>/ocr/<sha>.json),重跑命中缓存、不会再跑一遍 OCR。
心跳与僵尸任务:运行中的 job 每 15 秒续一次 heartbeatAt,并记 owner{pid,hostname}。
启动时扫描:心跳超过 90 秒且同主机进程已不存在 → 标 interrupted(面板不再空转轮询)。
Config 进设置页:export const Config(Schemastery)声明 11 个字段,激活时校验,
Config.listConfigs 从 absent 变成 schema。配置非法直接 fail loud,不会半配置启动。
字段与优先级(请求 > 配置 > 默认):
| 字段 | 默认 | 约束 |
|---|---|---|
dataDir | 空(<DSH_HOME>/course-assistant) | 路径 |
concurrency | 4 | 1–5 |
withVideos | true | 布尔 |
domain | 空(自动识别) | 字符串 |
ocrMaxPages | 60 | 1–400 |
ocrEngine | 空(自动) | windows / rapidocr |
ocrPython | 空 | python 路径 |
provider / model | 空(跟随默认模型) | 字符串 |
spacingMs | 1000 | 1000–60000 |
keepUploadsDays | 7 | 1–90 |
同名章节不再重复:页眉重复时只在标题变化处开新章;相邻同名章合并;
非相邻同名章追加页码区间(第 1 章 甲(p7–9)),不再出现"(续)"。
字号按 CTM 折算:有效字号 = Tf × √|det(Tm × CTM)|,q/Q/cm 维护图形状态栈。
用 cm 整体缩放的 PDF 不会被误判成"字很小"(Tz 只影响宽度,不参与字号)。
分章质量可量化:tools/gold/*.json 存人工/作者标注的章边界,
tools/segment-metrics.mjs 算 windowdiff 与 ±1 页容差的边界 F1;--real 组会跑 gold 集,
当前 deck-800 的 windowdiff 0.061、F1 0.947。
本地课件问答(零依赖):core/search.js 用 Node 内置 Intl.Segmenter 分词 + BM25,
在章节正文里检索并返回带章号与页码的原文片段。入口两个:
GET /course-assistant/ask?id=<jobId>&q=需求价格弹性怎么定义
# 或 Agent 工具:course_assistant { action: "ask", jobId, question }
检索索引在建报告时落到 jobs/<id>.index.json,章节重跑只替换该章的片段。
对照考纲算覆盖率(core/coverage.js):把复习大纲/考点清单交给它,按 token 重合把每条考点
归到最匹配的章节,输出每章覆盖了哪几条、以及没有任何章节覆盖的考点。
规则保守:至少命中 2 个词才算覆盖,避免「均衡」这种单字面重合造成假覆盖。
# Agent 工具
course_assistant { action: "coverage", jobId: "...", files: ["期中考点.md"] }
B 站推荐细化到分 P:对多 P 合集会再查一次 view 接口,用分 P 标题和章节标题/关键词做短语匹配
(短语整体命中优先,否则按 bigram ≥50% 判近似),命中就推荐「第 7P」并直接带 ?p=7 链接;
单 P 视频不会硬凑。分 P 信息有 24 小时缓存,每个章节最多查前 2 个视频。
增量课程:course_assistant { action: "append", jobId, files: [...] }
把新课件追加到已有课程:旧章节文本没变 → 摘要缓存命中不重算,只总结新增章节,然后重建整份报告
(实测:3 章旧 + 2 章新 → 5 章,cacheHits = 3)。
修掉一个长期的静默 bug:summarizeChapter 之前只拿到章节元数据,正文从未传给模型
(模型一直在只看标题写要点)。1.4.0 起正文显式传入,prompt 版本升到 v5。
1.3.0 新增:可换的 OCR、双栏阅读顺序、单章重跑
OCR 引擎抽象:core/ocr.js 变成注册表,引擎只需实现
{ id, label, available(), recognize(pdfPath, opts) }(约 30 行接口)。
| 引擎 | 平台 | 说明 |
|---|---|---|
windows | Windows | WinRT 渲染 + Windows OCR(zh-CN),开箱可用,~1 秒/页 |
rapidocr | 跨平台 | pip install rapidocr_onnxruntime pymupdf 后可用;渲染用 PyMuPDF,识别用 RapidOCR |
health.ocrEngines 逐个报可用性,界面上不装也能用(只是列出来 available: false)。
强制指定:ocrEngine: 'rapidocr',Python 路径用 ocrPython 覆盖。
双栏排版按栏读:论文/教材型 PDF 的内容流是「左一行、右一行」交错存的,直接顺读会把两栏串成一句话。 现在按每行/每段的 x 区间找一个「几乎没人跨过」的纵向沟槽(≥3 行在左、≥3 行在右、跨栏行 <18%), 命中就按栏重排,整页宽的行(标题、通栏图注)先冲掉两栏缓冲、保持文档顺序。 单栏页面不受影响(检测不命中就原样输出)。
单章重跑 + 差异视图:每章右上角「重跑本章」→ POST /rerun { jobId, chapterIndex }。
- 只重算这一章(缓存读取刻意绕过),其余章节、课程总结、系列课全部沿用
- 重跑后重建整份报告,报告里其他章节不受影响
- 面板就地显示差异:
+ [要点] …绿色新增、− [重点] …红色删除,另列新增关键词 - 差异按「要点/重点/难点 + 去空白后的文本」比对,换了说法才算变化
视觉回归:tests/visual.spec.mjs + playwright.config.mjs,用系统 Edge(channel: 'msedge',不下载 Chromium):
pnpm exec playwright test                     # 对比基线
pnpm exec playwright test --update-snapshots  # 刷新基线
跳转地址默认 http://127.0.0.1:54763,用 DSH_WEB_URL 覆盖;GUI 需要 dsh web 打印的带 token 地址。
夜间视觉回归(本机计划任务)
CI 里既没有 Host 也没有 token,真面板的 ARIA/截图只能在本机跑:
node tools/nightly-visual.mjs            # 与基线对比
node tools/nightly-visual.mjs --update   # 刷新基线
token 写在 <DSH_HOME>/course-assistant/web-token.txt(第一行是地址栏里 token= 的值),
或设环境变量 DSH_WEB_TOKEN;在「任务计划程序」里注册成每天执行即可。仓库里不保存 token。
安装 / 重载前置条件两条:装好 DeepSeek Harness;profile 里配好一个可用模型(缺失时会退回本地抽取摘要)。
装法一:让 Agent 装(最省事,已验证)
在 Harness 对话框里直接说:
帮我安装插件 dsh-course-assistant(用 plugin_manager,action=install_bundle,target 用包名)
Agent 会执行 install_bundle(target="dsh-course-assistant"),从 npm 装;application: applied 后刷新页面即可。
装法二:GitHub ZIP(不用 git、不用 Node,已验证目录结构)
- 打开 https://github.com/logb-1/dsh-course-assistant → 绿色 Code → Download ZIP
- 解压,得到
dsh-course-assistant-main/(这一层里有package.json) - 把这一层的绝对路径交给 Agent:
帮我安装这个目录里的插件:
C:\Users\你\Downloads\dsh-course-assistant-main
装法三:git clone(开发者)
git clone https://github.com/logb-1/dsh-course-assistant.git
npm i dsh-course-assistant        # 或者走 npm
然后 install_bundle,target 指向克隆下来的目录(绝对路径)。
装法四:github: 规格(可选,需能稳定连上 github.com)
install_bundle(target="github:logb-1/dsh-course-assistant")
已验证 pnpm 能解析并下载(21 个文件、cordis.patch.yml 齐全),但插件管理器会先做 5 秒 github.com 连通性预检,
网络差时会直接失败;另外 Windows 上若残留同名 junction 会报 EPERM。网络不稳时用装法一或二。
装好后刷新页面,左侧栏出现「课程助手」图标。
- 只想试用不装:
node tools/smoke.mjs <课件文件>需要插件已装(它打的是宿主路由)。 - 从零验证安装:
GET /course-assistant/health→{ok:true, version, llm, pdf}。
改源码后必须重载 Host:
remove_bundle+install_bundle。Node 的 ESM 模块在进程内缓存, 仅改文件不会热替换 Host 代码(Client 部分刷新页面即可重取)。面板与路由注册是否生效, 用GET /course-assistant/health与cordis_inspect_query(ClientSlots)确认。
数据目录:<DSH_HOME>/course-assistant/(uploads/ reports/ jobs/ cache.json),
默认 C:\Users\<user>\.dsh\course-assistant。可在 cordis.patch.yml 里用 dataDir 改。
配置(cordis.patch.yml 的同名列)
1.4.0 起这些字段由导出的 Config(Schemastery)校验,并在设置页可见;优先级统一为
请求参数 > 配置文件 > 内置默认。
| 键 | 默认 | 说明 |
|---|---|---|
dataDir | <DSH_HOME>/course-assistant | 上传/缓存/报告根目录 |
concurrency | 4 | 并发总结章节数,1–5 |
withVideos | true | 全局关闭 B 站检索 |
provider / model | profile 默认模型 | 覆盖总结模型(默认取 agentDefaultModel) |
domain | 自动识别 | 强制课程领域,如 C++;用于代码特征太碎、识别不出的文件 |
ocrMaxPages | 60 | OCR 重读的页数上限(1–400) |
ocrEngine | 自动 | windows / rapidocr |
ocrPython | python / python3 | rapidocr 用的解释器 |
spacingMs | 1000 | B 站请求间隔(≥1000) |
keepUploadsDays | 7 | 上传文件保留天数(1–90),仍被任务引用的不会被删 |
依赖
零 npm 依赖,只用 Node 内置能力:node:zlib(ZIP/deflate)、node:crypto(sha256/md5)、
全局 fetch(B 站)、officeToPdf(Host 服务,可选,用于 PDF 导出)。
宿主侧依赖的 Harness 服务:tools、webServer(必需),llm、agentDefaultModel、officeToPdf(可选,缺失时降级)。
架构
需求里给的是 Python 结构(manifest.json + main.py + bilibili-api)。Harness 的插件是
Cordis bundle(JS):package.json 声明 dsh.bundle.patch + dsh.client,Host/Client 各一个入口,
工具用 ctx.tools.register 注册,UI 用 ctx.slots 挂载。因此按官方规范落地为:
course-assistant/
├── package.json          # bundle 声明(exports / files / dsh.bundle.patch / dsh.client)
├── cordis.patch.yml      # 插入 course-assistant 行(配置就在这里)
├── index.js              # Host:HTTP 路由 + course_assistant 工具 + 任务表 + PDF 导出
├── client.js             # Client:拖拽面板(main + sidebar.panellist + composer.dock 三处注册)
├── core/
│   ├── zip.js            # 最小 ZIP 读写(OOXML 是 zip 容器;docx 导出也用它)
│   ├── pdf.js            # PDF 文本层 + 书签(对象扫描 / 对象流 / Flate+ASCII85 / ToUnicode CMap / 大纲)
│   ├── ooxml.js          # pptx / docx → 页文本 + 标题(占位符、字号、表格、标题样式)
│   ├── text.js           # 去页眉页脚/页码/模板行;md、txt 解析
│   ├── parser.js         # 统一入口:文件 → { title, pages | blocks }
│   ├── outline.js        # 目录识别:书签 → 标题层级 → §编号/章号 → 定长分块
│   ├── bili.js           # WBI 签名搜索 + 评分排序 + 合集识别 + 24h 缓存 + 风控降级
│   ├── summarize.js      # 固定 JSON 提示词、并发、JSON 截断修复、本地兜底
│   ├── report.js         # 报告拼装(附录两表)
│   ├── docx.js           # Markdown → 最小 docx,供 PDF 导出
│   ├── store.js          # 上传/任务/报告/TTL 缓存(原子写)
│   └── pipeline.js       # 编排:解析→目录→(总结∥检索)→总结→报告
├── locale/{zh,en}.json   # 插件管理器里显示的名称与描述
├── icon.svg              # 自绘图标
├── samples/              # 三个示例产物(pptx / md / pdf 输入)
└── tools/                # 开发期自检脚本(不随包发布)
时间线(实测,本机):
| 输入 | 冷启动 | 命中缓存 | 章节 | 视频 |
|---|---|---|---|---|
关上800美元的小门_课程汇报.pptx(34 页) | 23.4s | 6.2s | 10 | 30 |
计算机系统基础 复习&自学大纲.md(11 章) | 24.3s | 11.2s | 11 | 33 |
| 同内容 PDF(5 页,报告导出件) | 16.3s | 5.1s | 11 | 27 |
目标 ≤60s/50 页:满足。解析与目录识别是毫秒级,主要成本是模型调用与 B 站 1s/请求的节流; 两者并行,且每章拿到关键词就立刻检索,所以进度条前段就能看到结果。
B 站检索
- 端点:
api.bilibili.com/x/web-interface/wbi/search/type,请求前先取nav的wbi_img生成 mixinKey,参数按字典序拼接后md5(query + mixinKey)作w_rid(算法见下「借鉴来源」)。 - 每章最多 2 个搜索词(章节数 >12 时降为 1 个),每词取 10 条;全课程 3–4 个词取 20 条。
- 评分
= 匹配度×0.5 + log10(播放)×0.2 + 收藏/点赞×0.2 + 合集×0.1; 过滤时长 <3 分钟、标题/简介不含关键词、命中分 <0.28 的结果。 - 系列课额外要求「合集/系列/全套/教程」特征且命中分 ≥0.3,否则不硬凑,直接给 3 条搜索入口。
- 请求间隔 1s,失败重试 2 次;结果缓存 24h;触发 412 / -352 时整轮降级为搜索链接。
省 token 的做法
- 文本抽取、去页眉页脚、去页码、去模板行、按章分组全部在本地完成;
- 每章只发该章文本,截断到 3600 字(约 3000 tokens),提示词固定、输出固定 JSON;
- 模型返回的
keywords直接作为 B 站搜索词,不再单独调用模型; - 全课程总结只输入各章
key_points,不回灌原文; - 章节按文本 sha256 命中 30 天缓存(同文件重复分析几乎零调用),B 站结果 24h 缓存;
- 章节并发 4(
concurrency可调);模型不可用时用本地抽取式摘要兜底。
示例产物
示例报告不随仓库发布(含个人课程材料,体积也大):在本地跑一次即会重新生成。
| 文件 | 输入 | 说明 |
|---|---|---|
samples/<课件名>_学习报告.md | 34 页 PPTX | 主示例:10 章、30 个视频、3 个系列课 |
samples/<大纲名>_学习报告.md | 11 章 MD | 真实课程大纲,分章网课命中(CSAPP/袁春风/IEEE754/链接/存储层次…) |
samples/<大纲名>_学习报告.md | 5 页 PDF | 版式 PDF 的文本层解析示例 |
同名 .pdf | — | 由 officeToPdf 从 Markdown→docx→PDF 导出 |
用自己的课件跑一批:node tools/smoke.mjs <file> [<file>...](走 HTTP 路由,产出落在 samples/)。
验证状态
| 项 | 结果 |
|---|---|
| bundle 安装 | application: applied,warnings: [] |
| Host 路由 | GET /course-assistant/health → 200 {llm:true,pdf:true};upload→run→job→report(md)→report(pdf) 全链路通过(tools/smoke.mjs) |
| Client 槽位 | main key course-assistant active;sidebar.panellist id course-assistant active;conversation.composer.dock id course-assistant-dock active |
| 语法 | node --check 全部通过(index.js / client.js / core/*.js) |
| 回归 | node tools/regress.mjs 共 22 项:--unit 13 项(合成 PDF、可信度/证据、CTM 字号、分章指标、单章重跑、同名章、PPTX 节映射、导出结构)任何机器可跑;--real 9 项需要课件;--strict 下 unit 缺文件即失败 |
| CI | .github/workflows/ci.yml:Windows + Ubuntu 矩阵跑 --unit --strict 与 client 契约测试;package job 校验 tarball 清单(防 files 漏文件)与"版本号不许写死" |
| 分章质量 | tools/gold/*.json + tools/segment-metrics.mjs(windowdiff / 边界 F1,±1 页容差);deck-800:章 10/11、windowdiff 0.061、F1 0.947 |
| 解析 | pptx 34 页→10 章;pdf 5 页→11 章;docx 无标题样式→9 章(编号推断);md→11 章 |
| 报告 | 三份示例的附录两表均非空;总结合格(≤300 字) |
| PDF 导出 | 三个样本均生成 PDF,文字层可回读(自写解析器 round-trip) |
| 渲染效果 | tests/visual.spec.mjs:Playwright + 系统 Edge 打开面板、断言结构与基线截图(DSH_WEB_URL 需带 dsh web 的 token) |
已知限制
- 扫描版 PDF 没有文本层,只能拿到空文本 → 会报「疑似扫描版,需先 OCR」,请先转文字 PDF。
- 加密 PDF 直接拒绝;PDF 里 Type0 字体缺
/ToUnicode时该页文字解不出来。 - B 站是关键词检索,不是语义检索:对「研究汇报」型课件(本示例 PPT 讲贸易政策)噪声明显,
报告里同时给出搜索链接;标准课程(如
复习&自学大纲)命中率明显更好。风控时整轮降级为链接。 - 系列课推荐依赖标题里的「合集/全套/教程」特征,找不到合格项时只给搜索入口,不硬凑。
- 纯图幻灯片没有文字,只能给出标题级要点(模型被要求「不编造」,因此可能很短)。
- 模型输出截断(maxTokens 被推理吃掉)时用 JSON 修复 + 本地兜底摘要,此时该章会标「备注」。
- 单次最多 12 个文件、单文件 60MB;上传保留 7 天,报告长期保留,请自行清理
reports/。 - 不登录、不抓取任何 B 站账号信息;除 B 站公开搜索外不产生其他请求。
与社区同类插件的区别
发布前查过 DSH 社区(awesome-dsh-plugin 榜单、dshbase、npm dsh-plugin 检索)。相邻项目不少,按接近程度排列:
| 现有项目 | 它做什么 | 与本插件的区别 |
|---|---|---|
| linner1224/dsh-video-coursemap | 观察浏览器前台窗口识别视频课程,抓 B 站简介/字幕/弹幕/评论,生成 Markdown + Mermaid 知识地图与 Word 手册 | 同样接 B 站,但输入是「正在看的视频」;本插件输入是课件文件,产出是分章报告 + 网课推荐附录 |
| aix-plugin/ai-courses | 学习诉求 + 手头资料 → 结构化 AI 课程(大纲、知识点、图表、进度) | 目标最近(资料→大纲+知识点),但它建的是长期课程库;本插件只出一次性报告,且附录强制给 B 站网课 |
| Ame-Choo/dsh-study-coach | 把一门课拆成知识地图,逐单元记六档掌握度,每日任务 + 错题本 | 偏长期学习管理;本插件偏「一次读透一份课件」 |
| Kaiji-Z/dsh-plugin-lookatstudy | markdown 文件 / 本地文件夹 / GitHub 仓库 → 导学课程(课时解锁、间隔重复) | 输入是文本与仓库,不含 pptx/pdf/docx 解析;无网课检索 |
| chenw2759-wq/dsh-mindmap | 课件(PPT/PDF/Word) + 电子书 → 打印级复习思维导图 HTML | 输入侧重叠;输出是思维导图,不做网课推荐、不出分章 Markdown/PDF 报告 |
| @eduwork/dsh-knowledge-studio | ECNU 的「知识工作室」:文档/学习/音视频/思维导图一体 | 大而全的工作台(3MB+、多依赖);本插件是零依赖的单点工具 |
dsh-file-upload / @iamroven/dsh-web-file-upload | 只提供 Web 端文件上传能力 | 本插件自带上传,重点是「课件 → 目录 → 分章总结 → 网课」链路 |
没有找到「课件文件 → 目录 + 分章知识点/重难点 + B 站网课推荐附录 + Markdown/PDF 报告」这一条完整链路的同款。
GitHub 调研(第 0 步)
| 项目 | Star | 最近更新 | 可借鉴的部分 | 是否直接依赖 | 许可证 |
|---|---|---|---|---|---|
| Nemo2011/bilibili-api | 4.2k | 2026-07-06(已归档) | WBI 签名流程、搜索参数 | 否(Python,且已归档) | 未声明 |
| SocialSisterYi/bilibili-API-collect | 20.2k | 2026-01-30(归档) | WBI 算法说明、端点与返回字段 | 否(文档参考) | 未声明 |
| microsoft/markitdown | 191.7k | 2026-10-22 | 「先把各种格式统一成 Markdown、保留结构」 | 否(Python 运行时不在插件进程内) | MIT |
| scanny/python-pptx | 3.6k | 2024-08-07 | 幻灯片/占位符/表格的结构约定 | 否 | MIT |
| pymupdf/PyMuPDF | 11.0k | 2026-10-22 | 书签优先(get_toc())再落到文本规律 | 否(AGPL-3.0 与分发不兼容) | AGPL-3.0 |
| Stuk/jszip | 10.4k | 2026-09-09 | ZIP 读写思路(只用到 stored/deflate) | 否(自写 80 行,零依赖更稳) | MIT / GPLv3 双许可 |
| mozilla/pdf.js | 54.0k | 2026-10-23 | 文本层/CMap/大纲的处理顺序 | 否(整包约 10MB,插件内不划算) | Apache-2.0 |
结论:Python 侧的成熟库(bilibili-api / python-pptx / PyMuPDF)无法在 Harness 插件进程里直接使用, 而 JS 侧可选项要么体积大(pdf.js)、要么等于把 80 行 ZIP 读取换成依赖; 因此按它们的做法重写最小实现,并在源码注释里标注来源与许可证。B 站签名与端点以 bilibili-API-collect 的文档为准(该仓库已归档,故不引入其代码,只按文档实现)。
许可证
本插件代码 MIT。图标为自绘。示例报告(未随仓库发布)内容来自使用者自己的课件。
Comments
Loading…
From the same category
DeepSeek Harness plugin for Reactive Resume: bridges your resumes and job applications into a Harness session over MCP.
★ 41.7k
↓ 121/wk
MIT
Aug 24, 2026
dsh plugin --profile web add dsh-plugin-reactive-resumeby Tencent
Let AI agents use your real, logged-in browser without interrupting your work. CLI + extension for browser automation across any shell-capable AI agent.
★ 9.5k
↓ 8.7k/wk
MIT
TypeScript
Oct 23, 2026
dsh plugin --profile terminal add @wxg-prc-cpg/browser-skill-dsh-pluginby dsh-market
The plugin market inside DeepSeek Harness — browse, search, one-click install · DSH 可视化插件市场
★ 8.5k
↓ 163.6k/wk
MIT
TypeScript
Oct 23, 2026
dsh plugin --profile web add dshmarketby yjh051108
dsh-routing-suite — injector + router-standard kit: install the runtime injector first, then the task-aware reasoning-mode router preset (measured P1-P23).
★ 7k
MIT
JavaScript
Sep 18, 2026
dsh plugin --profile web add @dsh-external/dsh-super-injectorby Q00
Agent OS: the agent gets smarter on its own. We just hold the line: Interview-gated, staged evaluation, budgeted evolution loop. MCP server, 14 runtimes: Claude Code, Codex CLI, Gemini CLI, OpenCode,
★ 6.3k
MIT
Python
Oct 23, 2026
by superdesigndev
OpenRouter for agent tools. Join community here: https://discord.gg/6mQYYfFMAn
★ 6k
NOASSERTION
Python
Oct 23, 2026
dsh plugin --profile web add treg-dsh