

dsh-memj
Manifest validA dsh memory system built on project logic, where projects rely on handover documents and knowledge is derived from project accumulation. Following the logic of real-world work, it performs knowledge aggregation and handover. It opens up writing specifications and enables frontend editing of all plugin prompts (hot loading), allowing users to optimize on their own, or to let the model help plugins self-evolve through prompt modifications.
dsh-memj —— 让记忆跟着项目走
一个 DeepSeek Harness 记忆插件。
它只做三件事,但每一件都做到底:
| ① 知识跟着项目走 | 每条知识都归属一个项目。项目是记忆的单位——换会话、换机器,沿着项目就能找回全部上下文。 |
| ② 交接是主路径 | 把一轮工作压缩成下一轮的起点:项目文档 + 知识。压缩是可控、可编辑、可留档的。 |
| ③ 一切都开放 | 文档模板、知识类型、全部提示词都可在前端编辑。不改一行代码就能改变它的行为。 |
| ④ 用决策模型召回 | 提供了多种召回机制,包括以sidecar实时监测主会话,确定需求,由决策模型筛选注入知识的实验性找回方式 |
| AI写的readme.我再简单总结一下,插件把项目落一个可自由编辑规范的项目文档(交接文档),把这个文档作为项目实体,跨会话使用。插件会识别会话中的项目,会话中可沉淀的知识会与项目绑定。通用知识可以升级为主题知识或者全局知识,完全以人的工作逻辑去聚类(初筛)知识。就很自然。 | |
| 第4点当个噱头我也写前面吧。实际上Jev对于中文支持,以及以较长上下文作为state作为判据都有很多不足(但有解)。但我依然相信,以后不再需要本地的向量匹配和重排,哪怕是基于时效性、安全性和性价比的考量。 |
库就是一个目录(
~/.dsh-memj/),拷走即迁移; 项目文档与知识全部是 Markdown,可读、可 diff、可随时用编辑器打开。
快速开始
dsh plugin --profile web add dsh-memj
一条命令就够,装完不用重启。
- 📦 npm:https://www.npmjs.com/package/dsh-memj(
pnpm add dsh-memj也可) - 🐙 GitHub:https://github.com/jojoman2024/dsh-memj
- ⚠️ 需 DSH
0.2.0-rc.2(该版本在 npm 上是@next标签;latest是更老的0.1.0-rc.6) —— 详见 安装 一节
目录
三个设计核心(就在下面):
- 知识跟着项目走 —— 项目是记忆的主线:每条知识都归属一个项目,其下再按主题 / 全局 / 类型 / 标签多维度复用
- 交接是主路径 —— 项目文档本身也是交接文档,把一轮工作压成下一轮的起点,压缩可控、可编辑、可留档
- 一切都开放 —— 文档模板、知识类型、全部提示词都可在前端进行编辑。
其余部分:
① 知识跟着项目走
这是整个插件的设计核心。
memj记忆插件,基于项目的根本逻辑,沉淀的知识跟着项目走,在根据项目共性升级成为主题知识、全局知识。 按照最自然的行为逻辑,天然聚合知识,贴近用户本身的需求
项目是主线:每条知识都归属一个项目,项目文档就是它的总入口:
        ┌──────────────────────────────────────────────┐
        │  项目 = 记忆的主线                             │
        │                                               │
        │   HANDOFF-<项目>.md                           │
        │   ├─ 叙事:这个项目一路怎么走过来的             │
        │   └─ 知识索引:它旗下每条知识的一行说明          │
        └──────────────────────────────────────────────┘
             │                    │                 │
    聚合出共性 │          再提炼   │        同时打上    │
             ▼                    ▼                 ▼
      主题(跨项目通用) → 全局(无条件注入)   类型 · 标签
⭐ 但主线不等于唯一的检索维度 —— 一条知识同时带着:
| 维度 | 作用 |
|---|---|
| 项目 | 主线。它在哪个项目里被做出来的 |
| 主题 | 跨项目复用:这条知识别的项目也用得上 |
| 全局 | 跨主题通用,无条件注入 |
| 类型 | 它是事实 / 陷阱 / 流程 / 决策 / 留档 |
| 标签 | 自由词,和标题、描述同级参与检索打分 |
⇒ 所以模型既能"顺着项目"检索(我先看看这个项目里有什么), 也能"按话题"横着捞(凡跟"pnpm/发布"有关的知识,不管在哪个项目)。 两条路都通,而且可以叠加(例如"在主题 X 下,找带标签 Y 的")。
三个视图,对应三种问法
① 知识 —— 一条知识长什么样
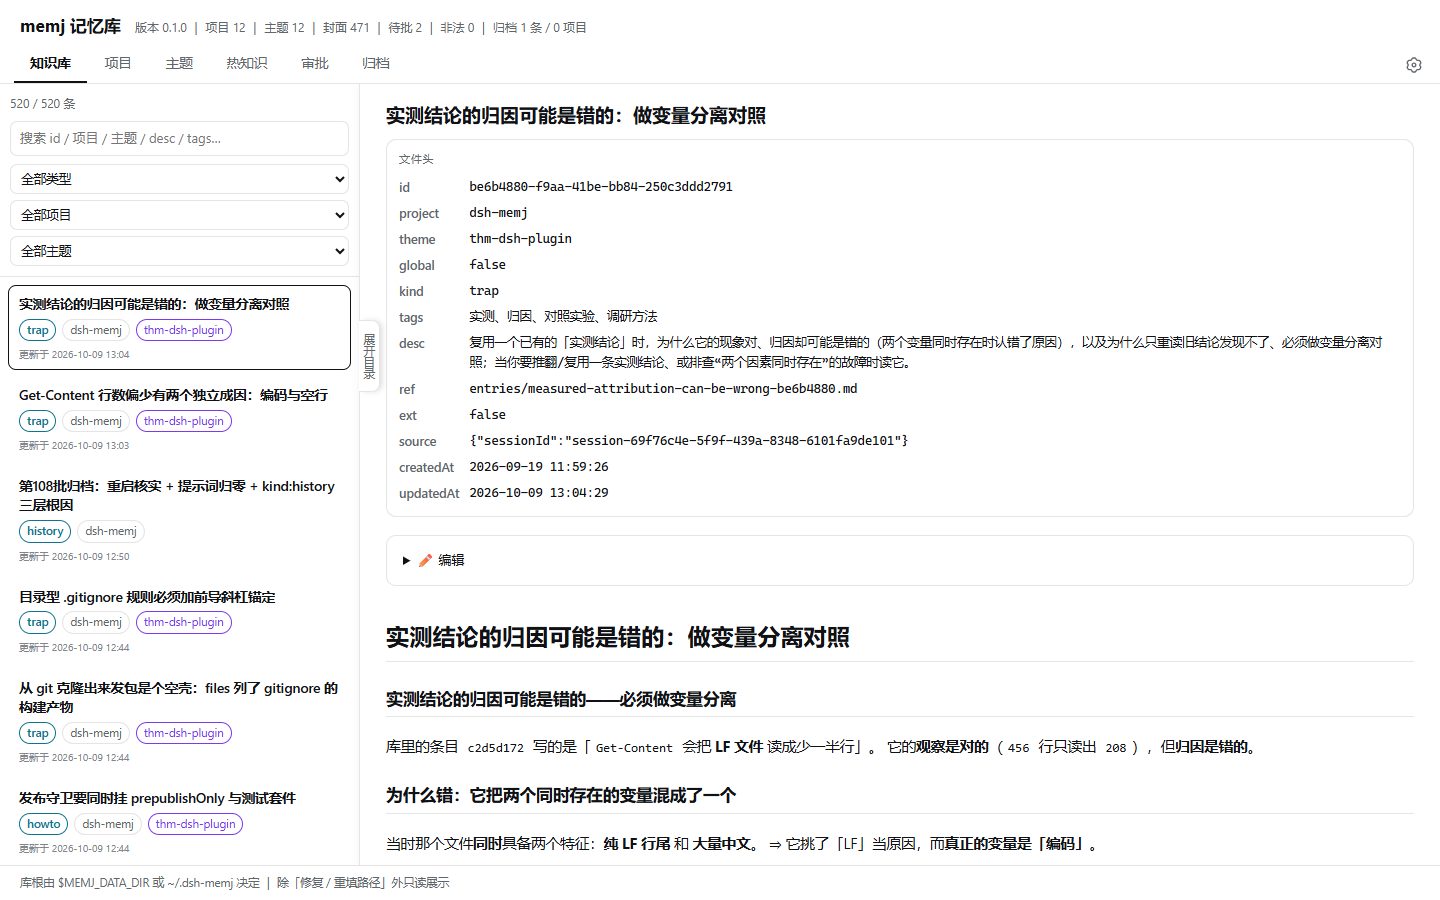
知识的封面归属可由用户进行二次编辑。
② 项目 —— 记忆的主线
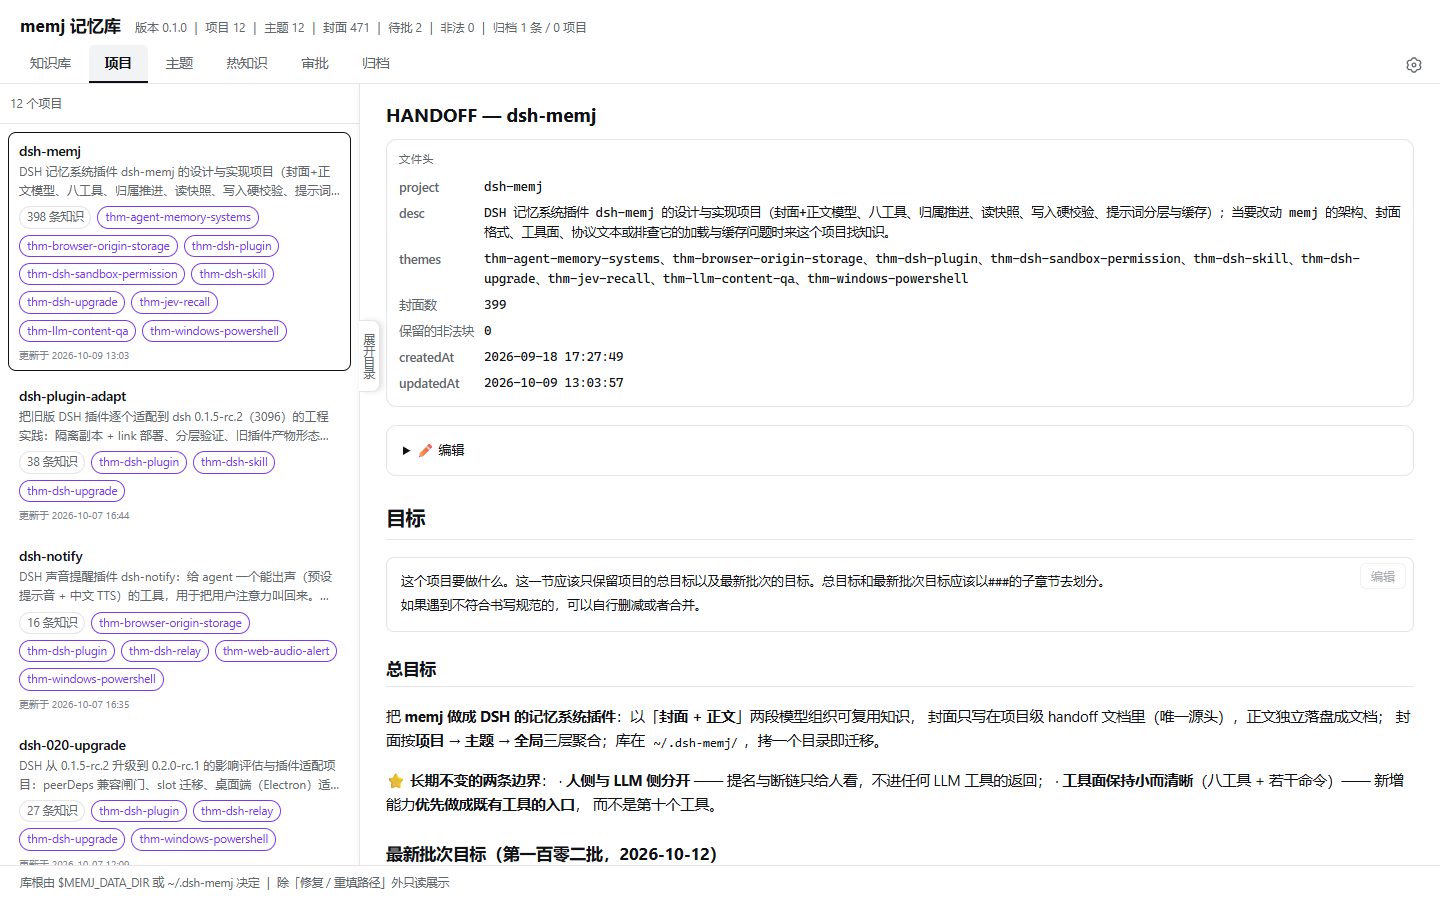
项目的归属同样可以进行编辑,项目文档的章节书写规范可在项目文档单独编辑,包括压缩和归档规则。
③ 主题 —— 跨项目的那条线
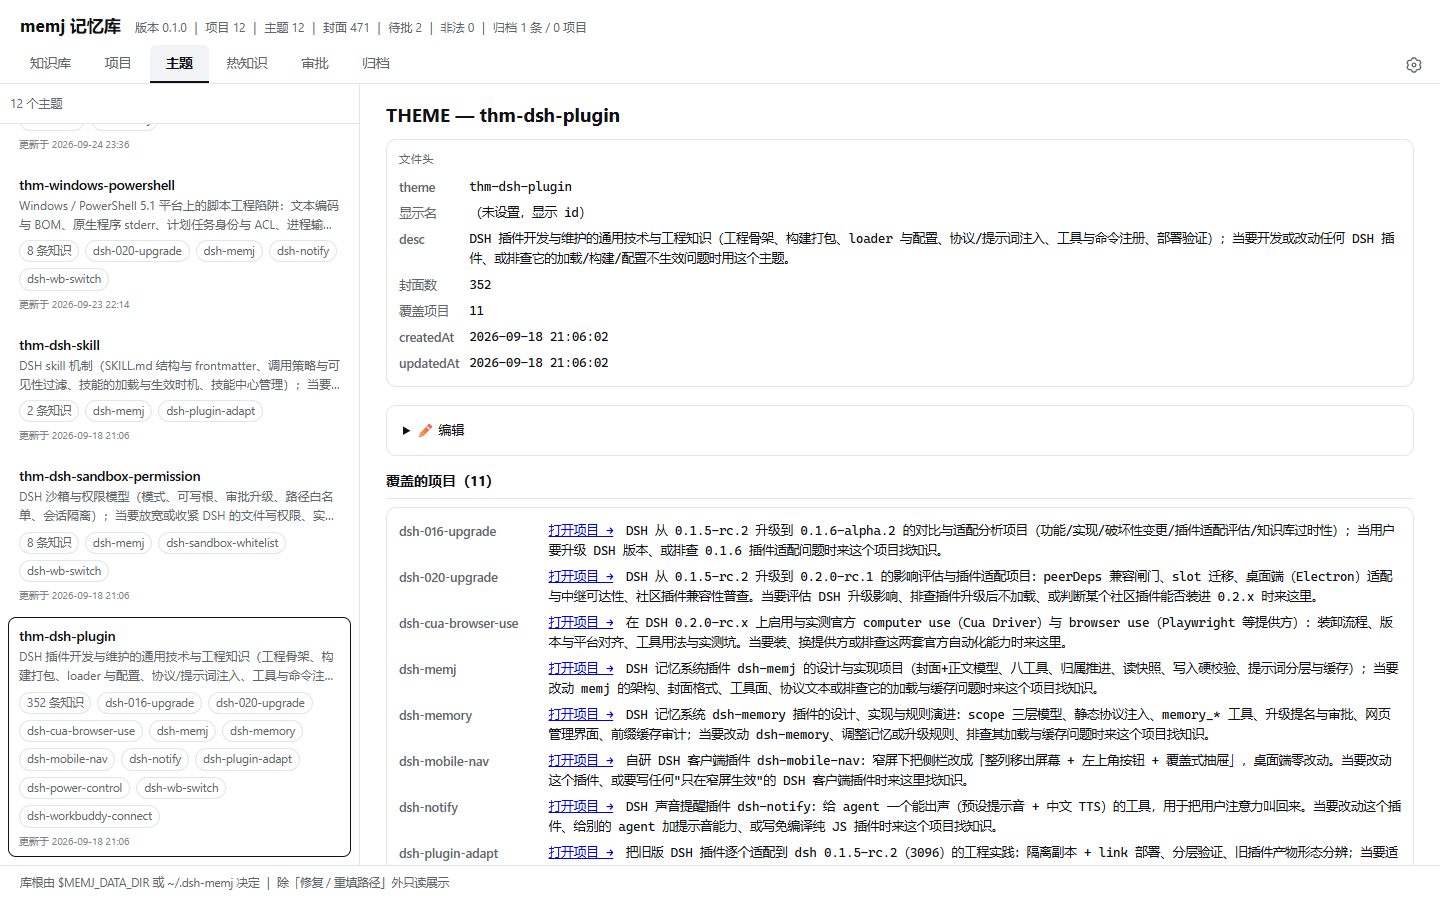
用户在新会话交接时,可以直接交接与项目相关的主题,获取相关主题的通用知识和关键上下文。
每个项目一份项目文档,它是这个项目的记忆总入口:
- 新会话接续这个项目时,读这一份就够——不用先猜"该搜什么关键词";
- 每条知识都挂在某个项目下,索引就写在那个项目的文档里 ⇒ 顺着项目走下去,知识自然被带出来。
它和"一个扁平的大知识库"有什么不同:
| 扁平知识库 | memj | |
|---|---|---|
| 主线 | 没有,全靠关键词 | 项目——有确定归属,不会散落 |
| 找东西的入口 | 你得先想出关键词 | 以项目自然聚类知识,缩小召回范围更贴实际需求 |
| 换个角度找 | —— | 主题 / 标签横着捞,两条路都通 |
| 换了会话 / 换了机器 | 上下文要重建 | 沿着项目捡回来 |
⭐ 判据一句话:换一台机器、换一个会话,沿着"项目"能不能把上下文捡回来? 能 —— 这就是它要达到的效果。
⚠️ 为什么把项目当主线,而不是只按话题组织:话题会重叠、会变名、颗粒度难以控制, 光靠话题收不住——一件事做完了,相关的话题还在长。 而项目是有边界的:一件事做完了就是做完了,边界清楚。 ⇒ 主线负责"收得住",主题、标签、关键字负责"捞得着"。
② 交接:把一轮工作压成下一轮的起点
交接(handoff)是本插件的主路径。
它解决的问题是:怎么让老窗口的上下文压缩可控,可留档。怎么让新窗口不用从头交代背景。
说一句「做一次交接」或输入 /memj-handoff,它会引导模型把这一轮的成果落成两样东西:
| 落到哪 | 是什么 | 给谁看 |
|---|---|---|
| 项目文档 | 这一轮的进展、踩的坑、定下的方案 | 下一个接手的人(或模型) |
| 知识条目 | 可复用的结论:下次遇到同类问题该怎么办 | 将来任何一次检索或注入 |
⭐ 为什么必须是它,而不是"让模型写个总结":
| 随手写的总结 | memj 的交接 | |
|---|---|---|
| 写到哪 | 聊天记录里,翻不回去 | 项目文档,有确定位置 |
| 写什么 | 模型自由发挥 | 由你写的规范决定(每节该写什么) |
| 下次怎么用 | 你得记得有这回事 | 新会话读项目文档即可接续 |
| 会不会丢 | 压缩后可能被丢掉 | 落盘成文件,永不被压缩 |
| 能不能改 | 改不了 | 普通 Markdown,直接改 |
| 会不会越写越长 | —— | 有留档机制(原文照收,不是有损摘要) |
⭐ 本质是一次主动压缩——把一轮百万 token 的过程,压成几 KB "下一轮真正需要知道的"。但这次压缩是可控、可编辑、可留档的。
- 可控:压缩成什么样,由你写在项目文档的规范里(哪一节留什么、多少字该整理)。
- 可编辑:压完就是普通 Markdown,你可以直接改;改完下次交接照样沿用。
- 可留档:项目文档越写越长时,交接把最早写下的那些小节整段原文收进一条
history留档知识,原处只留一行指针(完整 id + 一句话主题)—— ⭐ 所以压缩可以一直做下去,而原文一个字都没丢、随时能按 id 读回来。
⚠️ history 留档照常存在库里、在知识库页看得见、按 id 读得回,
但不参与检索(搜索与热知识注入都会跳过它)——它不回答"下次该怎么做",
只负责"当初到底写了什么"。
⭐ 若把一段被取代的原文写成别的类型,它就会正常参与检索(通常不是你想要的)。
💡 这就是它和"让模型摘要一下"最关键的区别: 摘要是有损的、而且你事后无从核对;留档是无损的、指针一直指得到原文。
它同时是"人"和"模型"之间的交接:你随时可以打开项目文档看它记了什么、 写得不对就直接改——记忆不是你无法插手的东西。
不做全量交接也行:只想沉淀知识、不想动项目文档,或者反过来只更新文档不落知识, 都可以分开做(见 四种使用方式)。
③ 一切都开放:模板、类型、提示词都由你定
memj 把三处本来该你说了算的东西全部开放出来。这三处正好对应 "记忆长什么样"、"知识分几类"、"模型被怎么指挥"。
a) 文档模板与书写规范 —— 决定记忆长什么样
节名、节数、每节要干什么,都由你定:
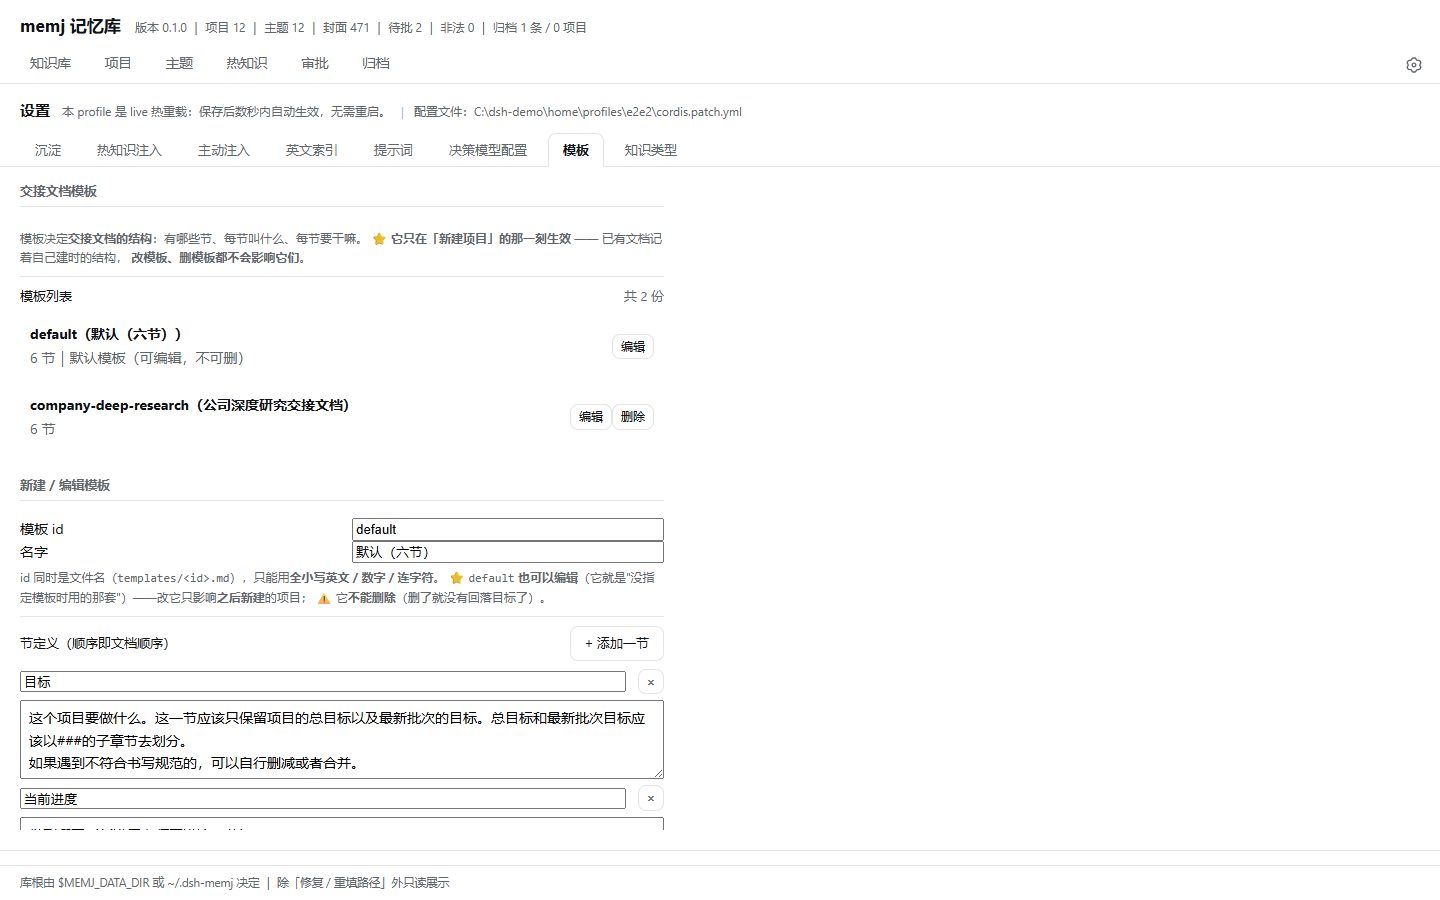
- 模板只在【新建项目】那一刻生效;已有项目记着自己的结构,改模板不影响它们。
- ⚠️ 节名不是文案,是程序协议 —— 读文档、重建骨架、统计信息都按节名来。
- ⭐ 每节标题下面那段规范,就是"这一节该写什么"(建模版时从模板复制过来), 模型读文档时会拿到它、按它写;
- ⭐ 规范可以就地编辑:项目详情页每一节的规范块上都有「编辑」入口。
⇒ 你可以把项目文档改成你自己的工作方式:做研究的用"公司画像/竞争格局",
做工程的用"接口契约/踩坑记录"。留档规则也写在这里
(例如"这一节超过 20000 字符就把最早的小节收进 history 留档")。
b) 知识类型 —— 决定知识分几类
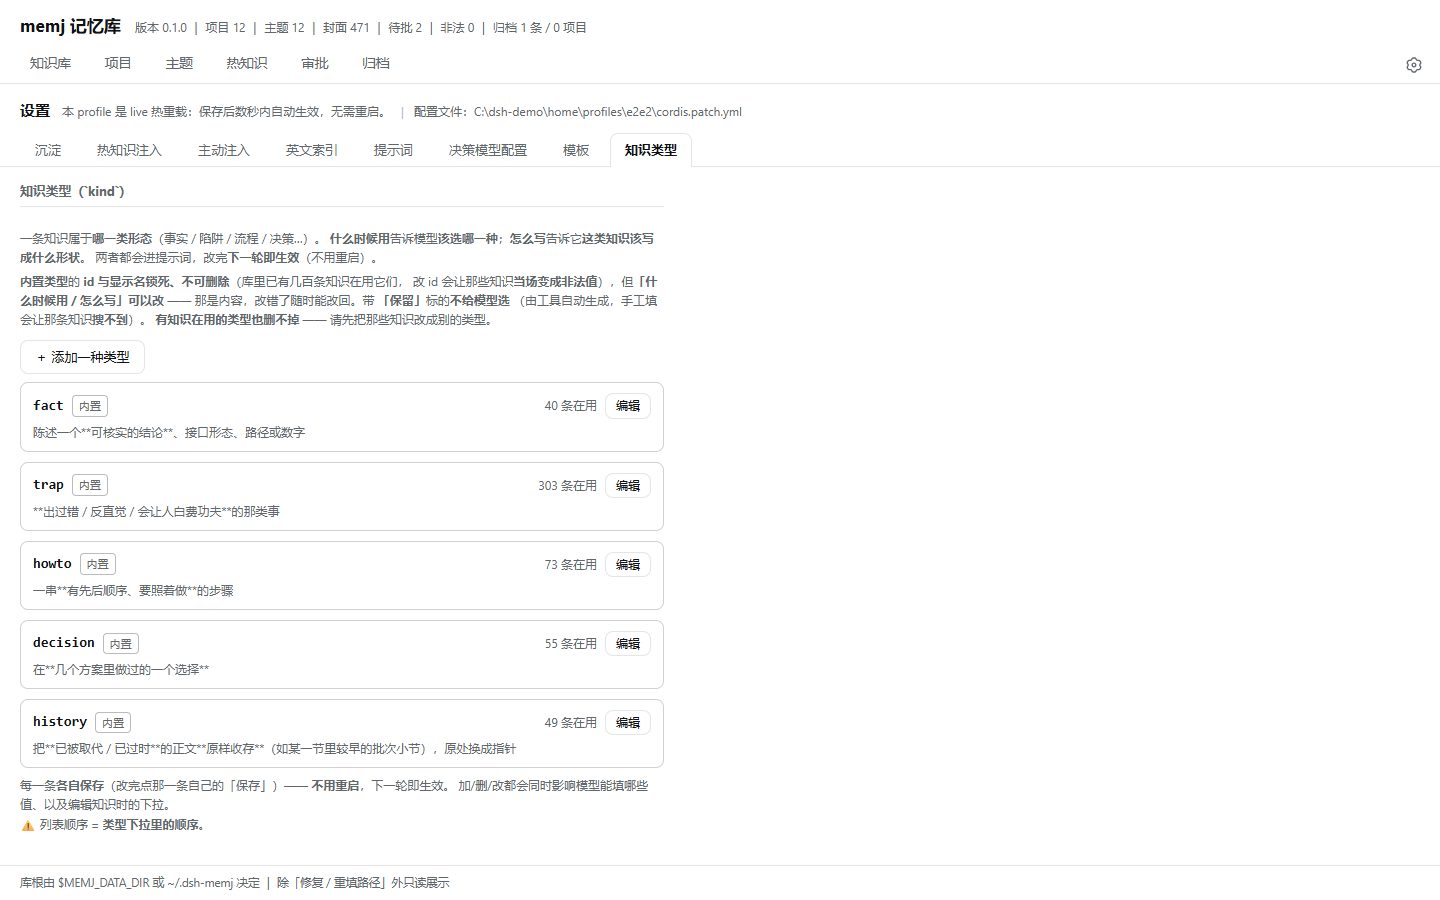
一条知识属于哪一类形态,由你的词表决定。内置五种:
fact 事实 / trap 陷阱 / howto 流程 / decision 决策 / history 留档。
改它同时影响三处:模型能填哪些值(工具参数)、写库时的下拉、以及 "这类知识该怎么写"的指导语。
- 内置类型的 id 与显示名锁死(库里已有几百条知识在用它们);
- 「什么时候用 / 怎么写」可改,改错了随时改回;
c) 提示词 —— 决定模型被怎么指挥
写给模型的每一段文本——协议、使用指导、11 个工具的说明、命令文案、 各类内部提示词(评分、标签规范化、翻译、模板写作指导)——都能改:
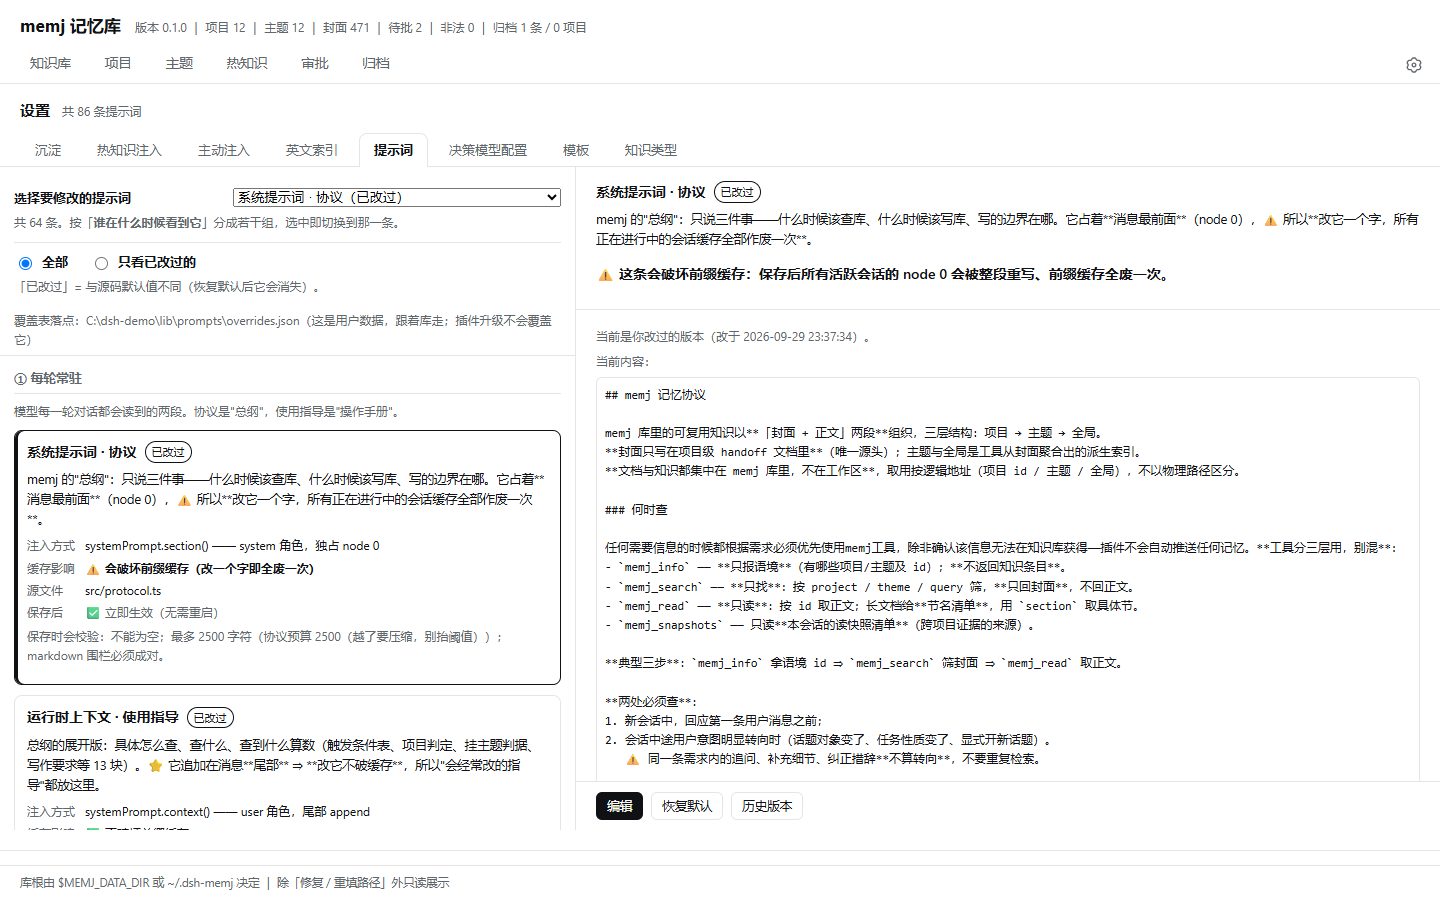
| 特性 | 说明 |
|---|---|
| 86 条 / 其中 64 条可编辑 | 按「谁在什么时候看到它」分组,每组带一句说明 |
| 改完即生效 | 存在库里,运行时内存覆盖源码设置(命令描述除外) |
| 可随时恢复默认 | 每条都能以源码设置为基线一键恢复 |
| 能写回源码 | 把库里的临时覆盖固化进源码,成为新的默认值 |
| 不怕改坏 | 带校验。长度上限;插槽校验(漏了/写错名字会被拒,并列出可用插槽) |
⭐ 它为什么重要:模型的行为很大程度上由提示词决定。 把这些交给你 ⇒ 如果用户有意愿和能力,完全可以设计目标让模型去循环优化提示词,在不改代码的情况下, 实现插件的自进化。
⭐ 前缀缓存:使用指导走
context()(消息尾部),改它不破缓存; 协议走section()(消息最前面 node 0),改它会破一次缓存——页面上明确标出。 ⚠️ 命令描述是例外:注册时已固化,改它要重启。界面上标注了每条的热生效档位。
归属三层与升级机制
知识按 项目 → 主题 → 全局 三层聚合。归属是累加,不是搬家: 一条知识加了主题仍然是项目知识;加入全局仍然命中原来的主题 —— 所以它不会"升级上去就从项目里消失"。
项目(project)   只对这个项目成立的知识        ← 绝大多数知识在这里
   ↓ 提炼共性
主题(theme)     跨项目通用的那类(如「DSH 插件开发」)
   ↓ 再提炼
全局(global)    跨主题通用,无条件注入
⭐ 这三层是"主线 + 复用"的关系,不是替代: 项目回答"它在哪做出来的",主题回答"别的项目能不能直接用", 全局回答"是不是每次都该带上"。一条知识可以同时命中三者。
升级是显式的、可审阅的:
- 升主题:写库时声明
theme,并必须引一句该主题描述里的话作为依据 (工具会核对这句话是否真的在描述里——引不出会警告,提醒你重新判断)。 - 升全局:登记提名,由人侧审批页批准后才真正生效 —— 模型不能自己批准。
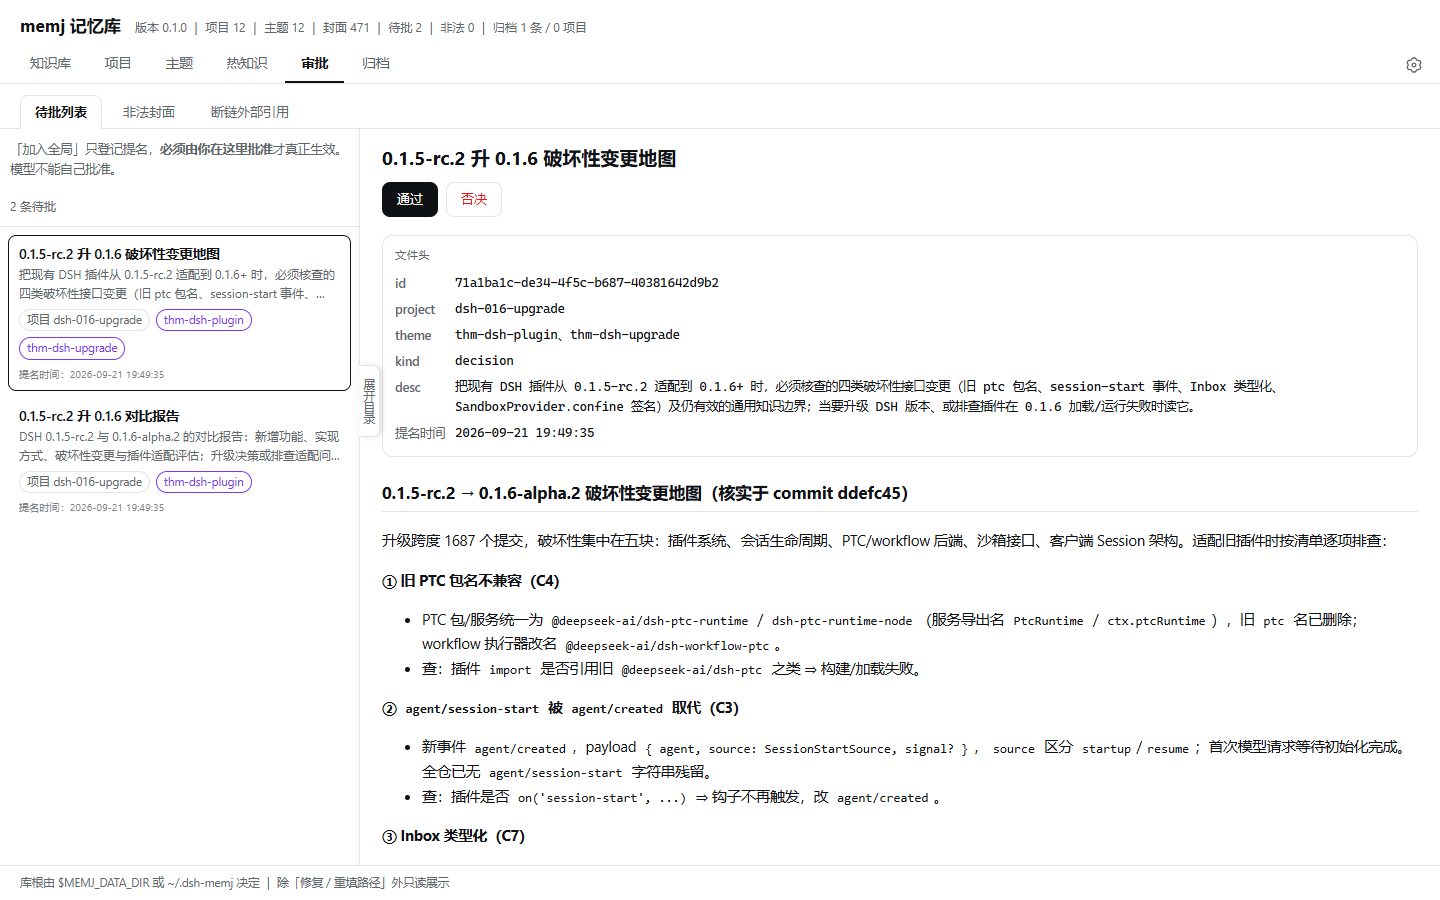
上图就是那个审批关口:左边是待批清单,右边能看这条知识的完整归属与索引
(project / theme / kind / desc),下方是原文,看清楚再点「通过 / 否决」。
⇒ 这是本项目的一条硬边界:提名只给人看,模型能提、不能批。
⚠️ 升主题的门槛是有意的:判据是 「这条知识给该主题描述的那个场景下的【别的项目】用,成立吗?」 只对本项目成立的(某次改动、某个接口、某处实测数据)不挂—— 漏挂只是主题视图里少一条(可事后补),误挂会污染所有项目看到的主题视图。 ⭐ 反过来说:一条知识没挂主题,不代表它不能被检索 —— 它照样能按项目找到、按类型筛、按标签查出。
项目文档长什么样
每个项目一份 HANDOFF-<项目>.md,是活文档——记录这个项目一路怎么走过来的,
不是"此刻的快照"。
它由正文和前端不可见的知识索引组成:
## 目标
> 这一节该写什么 —— 模型读文档时会拿到这段规范,按它写
(这一节的内容……)

## 当前进度
(这一节的内容……)

……(节名与节数由你的模板决定)

---


(文件末尾:这个项目旗下**全部知识的索引**,每条一行)
- 标题 · 场景描述 · 归属 · 类型 · id
⭐ 索引只存在于项目文档里(唯一源头) ⇒ 不会出现"两份清单对不上"。 检索时只读这些索引,不必打开任何知识全文。
知识怎么存、怎么找
一条知识 = 一个独立 Markdown 文件(entries/<slug>-<uuid8>.md)。
项目文档(索引:标题 + 场景描述 + 归属)
        │  只需要它就能判断"有没有我要的东西"
        ▼
知识全文(独立文件,确认要用时才读;长文档还能按节读)
⭐ 这个拆分解决的是**「查得动」与「读得少」的矛盾**: 合在一起的话,每次检索都得把几千字的知识全文读一遍,而其中绝大多数这次用不上。
模型侧典型三步:
memj_info    拿语境 id(有哪些项目 / 主题)
  ↓
memj_search  筛知识 —— 只回标题与描述
  ↓
memj_read    取全文(长文档给节名清单,用 section 取具体节)
memj_search 的四个筛选维度可以任意叠加:
| 参数 | 作用 |
|---|---|
project | 按归属项目筛 —— 顺着主线看"这个项目里有什么" |
theme | 按命中主题筛 —— 横着捞"别的项目里同类的东西" |
kind | 按形态筛(事实 / 陷阱 / 流程 / 决策 / 留档),与上面两个正交 |
query | 检索词数组,在标题 / 描述 / 标签上打分(各自权重不同) |
⇒ 例如「在主题 X 下,找带某关键词的陷阱类知识」是一次调用就能表达的。
11 个工具,各管一件事:
| 工具 | 干什么 |
|---|---|
memj_info | 只报语境(有哪些项目/主题及 id),不返回知识 |
memj_search | 只找:按 project / theme / kind / query 筛,只回标题与描述 |
memj_read | 只读:按 id 取全文;长文档给节名清单,用 section 取具体节 |
memj_snapshots | 读本会话的读快照清单(跨项目证据的来源) |
memj_handoff | ⭐ 写库主入口:叙事 + 索引 + 建主题 + 落盘知识 |
memj_promote | 推进归属 / 改索引字段 / 项目与主题级操作 |
memj_update | 更新已有一条知识的全文与索引字段 |
memj_rebuild | 从项目文档重建派生层(主题 / 全局) |
memj_template | 管理文档模板(两段式确认) |
memj_normalize_tags | 标签规范化(合并同义、去泛化、补英文) |
memj_score_turn | 轮末复盘评分(由子代理调用) |
⭐
memj_read匹配不到节名时会回【节名清单】,这不是报错而是设计: 否则会形成"想按节读就得先知道节名、取节名只能先读全文"的死循环。
四种使用方式
① 交接(主路径)
说「做一次交接」或 /memj-handoff —— 项目文档 + 知识一次落盘。
② 单独沉淀知识
只想记一条、不想写交接?说「把这条记到知识库」,
用 step: 'knowledge' 只落知识,项目叙事一字不动。
③ 只写 / 只改项目文档
step: 'narrative' 只更新文档;docSection + docOp 可以只动一节
(append / prepend / replace / drop),不必重写整篇。
④ 直接问库
模型按需调 memj_search / memj_read——两条路都能走:
- 顺着项目问:「
dsh-memj这个项目里有哪些关于发布的坑?」 - 按话题横着问:「不管哪个项目,凡是跟 pnpm / 打包 / 发布有关的都捞出来」
- 按形态问:「有哪些是"陷阱"类的?」(
kind维) - 叠加:「在主题『DSH 插件开发』下,找带某关键词的流程类知识」
你也可以用斜杠命令:
/memj-get-handoff-project、/memj-get-handoff-theme、/memj-review。
⭐ 叙事与知识分离:项目文档写"这个项目是怎么走到今天的", 知识写"下次遇到同类问题该怎么办"。前者解决接续,后者解决复用。
三种召回机制
memj 默认不推——它假设模型会主动查。但 LLM 的工具调用主动性并不稳定, 所以另配了三种可选的召回通道(都默认关,用哪个开哪个)。
① 热知识注入 —— 把相关知识推进上下文
会话开始时,把与本次会话相关的知识(标题 + 场景描述)注入进去; 并带一个看门狗:检测它们是否还在模型可见的窗口里, 丢了就补注、有新的就增量补(只补缺的那几条,不重发全量)。
来源有四层,逐条可设:用户画像 / 全局知识 / 项目知识 / 主题知识。 人侧面板分三个视图,各回答一个问题:
① 会话实时状态 —— 这一次到底注进去了什么
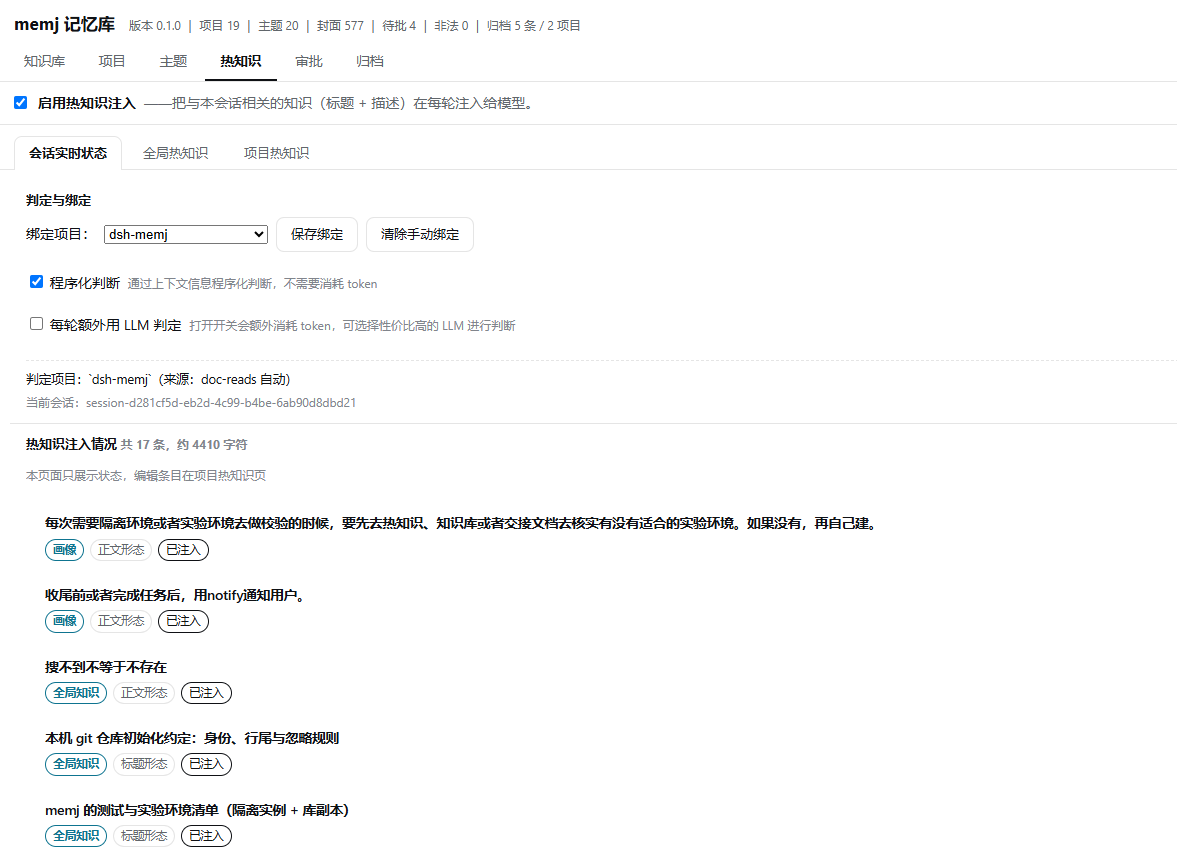
回答"为什么模型看到了 / 没看到":
- 判定与绑定:这个会话被判定成哪个项目,以及怎么判的
—— 上图显示判成了
dsh-memj,来源标注为doc-reads 自动; 也可以手动绑定,或勾上"每轮额外用 LLM 判定"(会额外消耗 token)。 - 热知识注入情况:本次共 17 条 / 约 4410 字符,逐条列出它来自哪一层
(
画像/全局知识/项目知识)、以什么形态注入 (标题形态= 只给标题 + 描述;正文形态= 连知识全文一起给), 以及是否已注入。 - ⚠️ 这一页只读(要改条目去「项目热知识」页)—— 它是验收视图,不是编辑视图。
② 全局热知识 —— 无条件注入的那部分
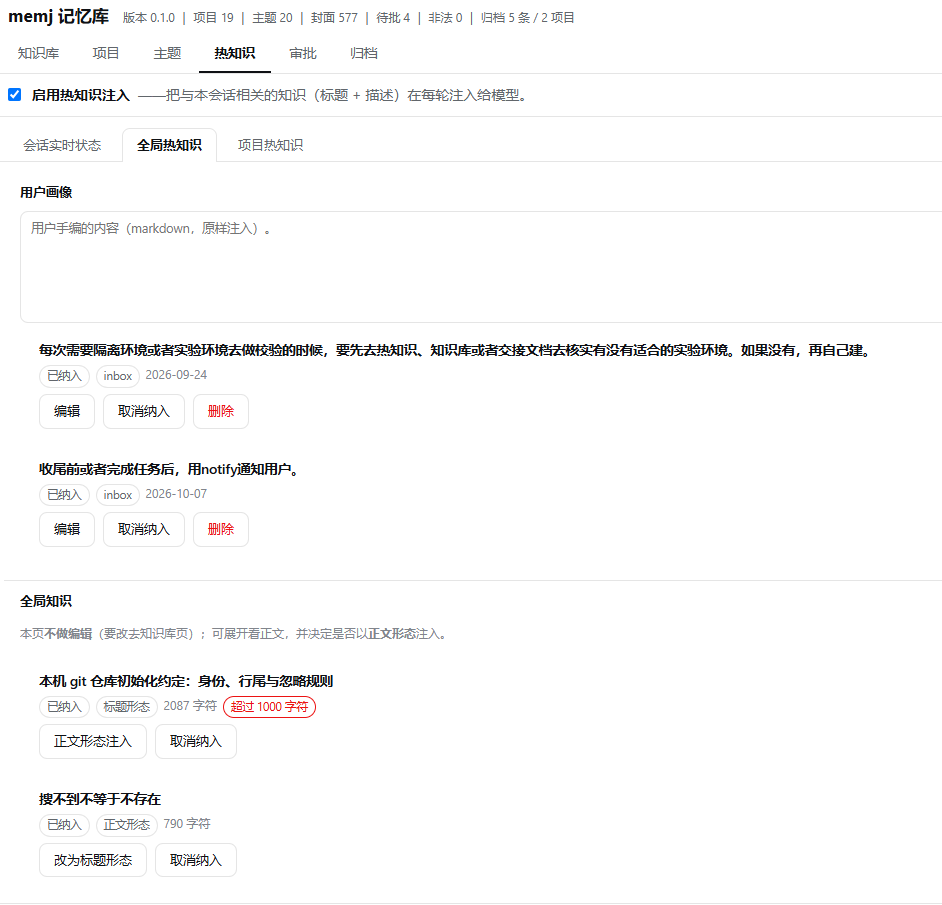
- 用户画像:你手写的内容(Markdown,原样注入),逐条可「编辑 / 取消纳入 / 删除」。
- 全局知识:跨主题通用的那些 —— 本页不做编辑(要改去知识库页),
所以按钮只有「取消纳入」和切换注入形态(
正文形态↔改为标题形态)。 - ⭐ 每条都标了字符数,超预算的会标红(上图那条 2087 字符就标了「超过 1000 字符」) —— 因为「正文形态」是连知识全文一起注入,一条就能吃掉大半个预算。
③ 项目热知识 —— 按项目圈定"这个项目该带哪些"
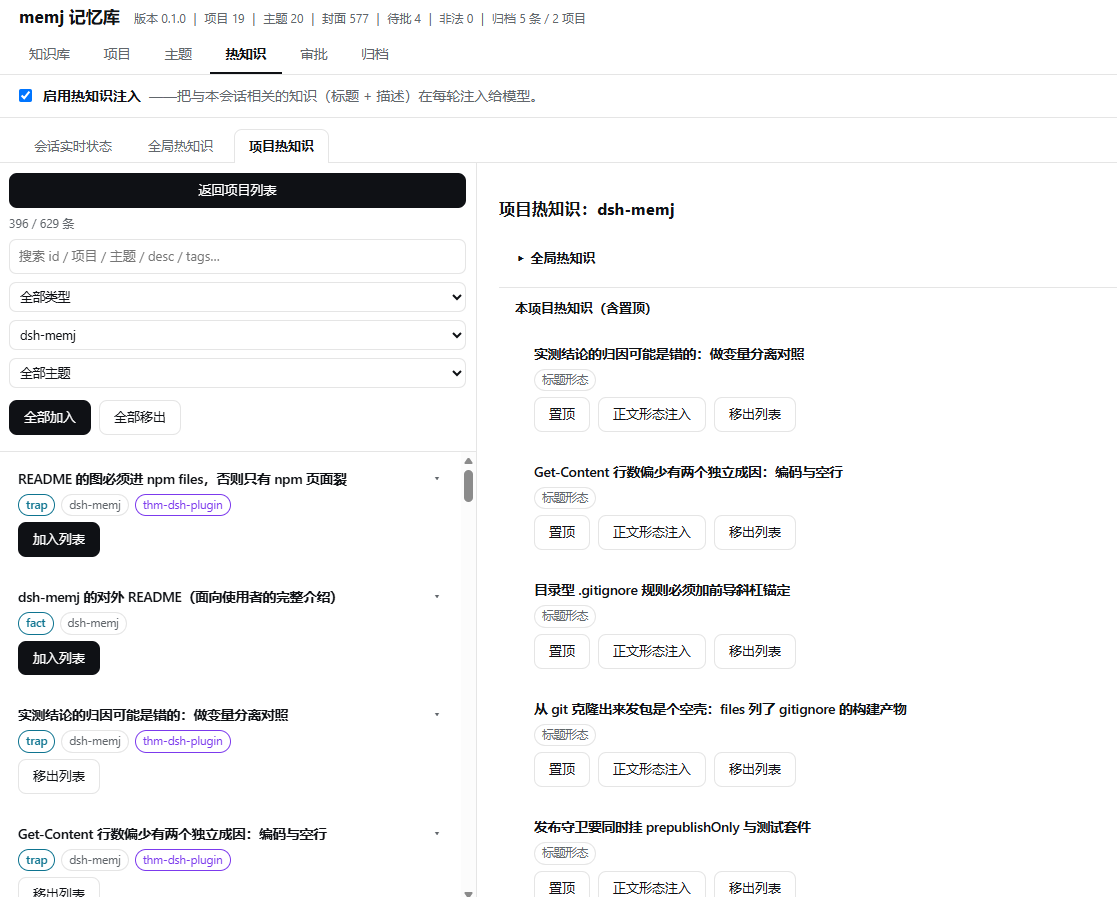
左侧是从知识库里筛出的候选(可按类型 / 项目 / 主题筛,也能「全部加入 / 全部移出」), 点「加入列表」把它纳入;右侧是已纳入的清单,每条可:
- 置顶(排在前面,优先注入);
- 切换注入形态(
标题形态↔正文形态); - 移出列表。
⇒ 三个视图合起来是"配置 → 生效 → 验收"的闭环: 在 ②③ 里配,在会话里生效,在 ① 里看得见到底注进去了什么。
② 轮末评分 —— 决定"下次先注入谁"
每轮结束时起一个子代理复盘这一轮:问的不是"用到了什么", 而是「假如它手上有这条知识,会不会做得更好」——发现"该给但没给"的那些并加分。 分数按项目存,热知识注入时取有效分前 N 名(滚动窗口,长期不用会自然掉出去)。
⭐ 价值在于发现缺口:已经注入过的知识再加分没有意义。
③ 主动注入 —— 模型没想到用工具时,替它把知识取来
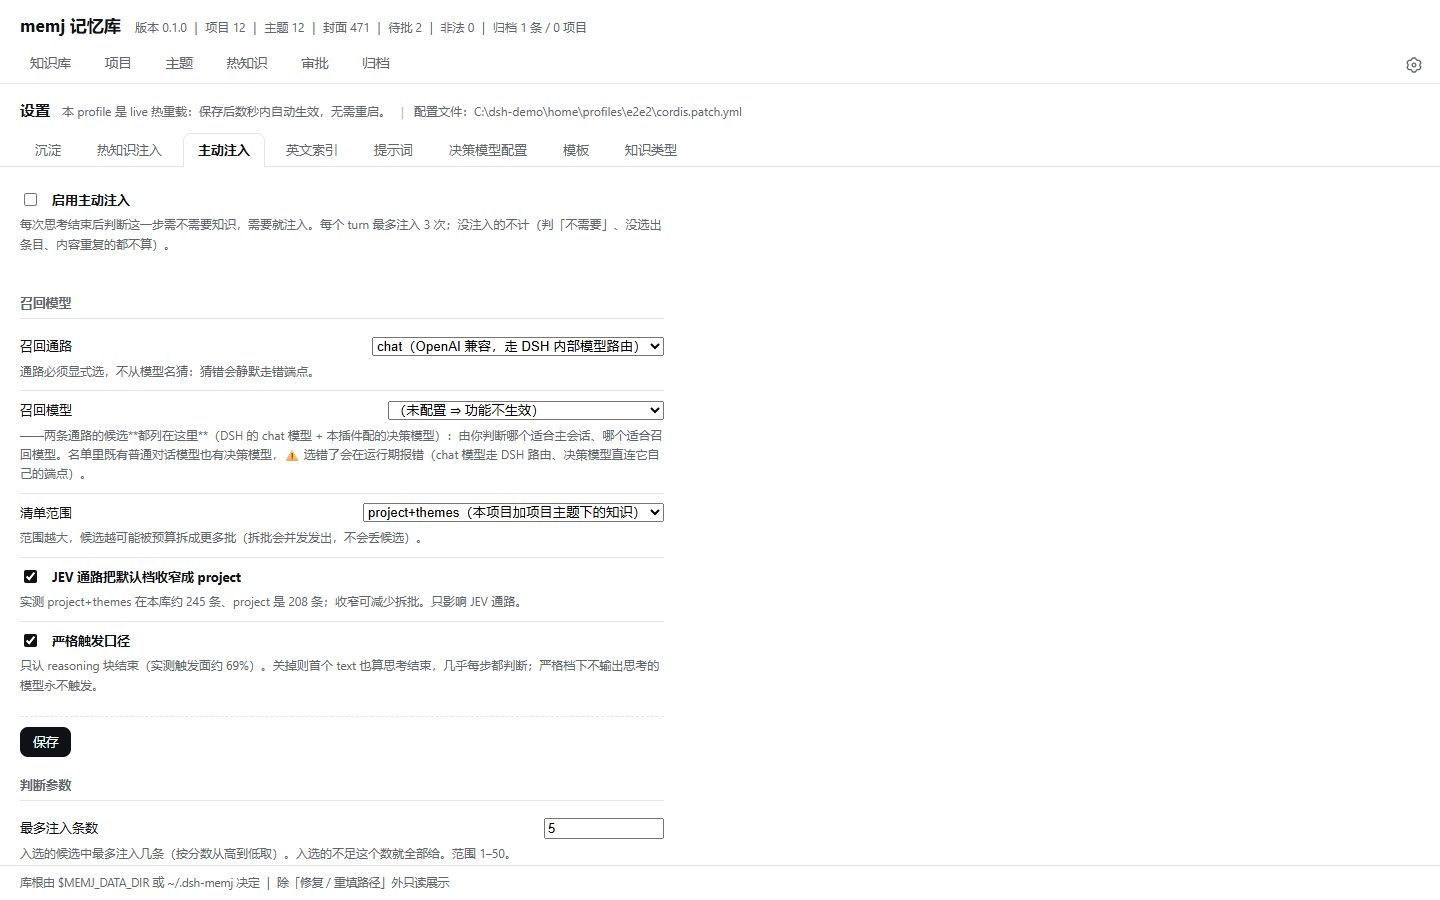
一个 sidecar 判定:主模型思考结束后,判断这一步需不需要知识、 以及模型的动作。如果所需知识在库里、而模型没有尝试去用工具, 就直接把所需知识注入会话。
- 判定模型可配置:推荐 JEV 这类决策模型,或 DS4.1 等高吐出模型 (关掉思考等级时也可用)。
- ⚠️ 属实验功能,效果与你的模型/场景强相关,可自行摸索。
- 因为部分决策模型(如 JEV)对中文输入支持有限,专门配了 英文翻译通路并配合召回索引 —— 翻译模型可自行配置。
三道门(意图 / 充足 / 需求)与预算、并发、拆批都是可调旋钮,
每次召回的判据都落盘(recall-log/),调参时从真实分布读,而不是猜。
人侧面板
入口在 DSH 侧边栏底部 —— 「memj 记忆库」:
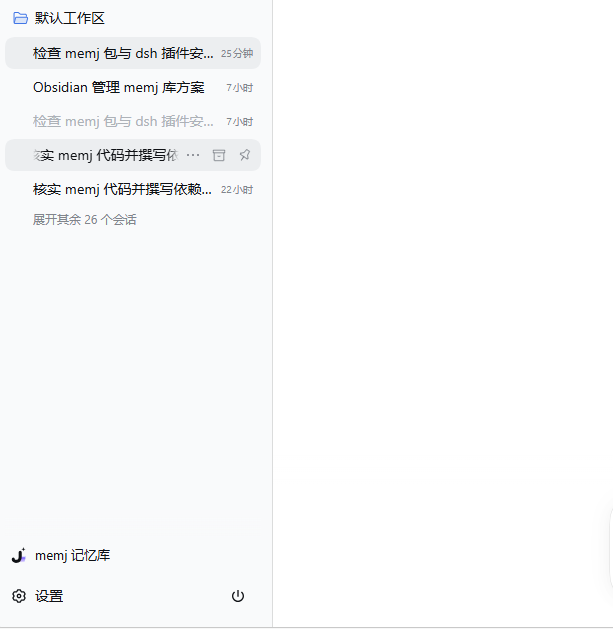
点它在独立浏览器标签页打开(/plugins/dsh-memj/),
不挤占会话窗口,而且窄屏(手机)同样可用(两级导航 + 折叠筛选)
—— 手机上看记忆库不必和会话抢地方。
| 页 | 干什么 |
|---|---|
| 知识库 | 搜 / 筛 / 读全文;编辑归属;按 id 直达 |
| 项目 | 项目文档全文 + 规范就地编辑 + 它聚合的知识与主题 |
| 主题 | 跨项目的共性知识视图 |
| 热知识 | 开关、会话实时状态、按项目的清单、全局知识、用户画像 |
| 审批 | 批准 / 否决 global 提名;格式非法的知识;断链外链 |
| 归档 | 把不再活跃的知识 / 项目下架(可随时恢复)—— ⚠️ 与上面的 history 留档是两回事 |
设置页 8 个子页:沉淀 · 热知识注入 · 主动注入 · 英文索引 · 提示词 · 决策模型配置 · 模板 · 知识类型。
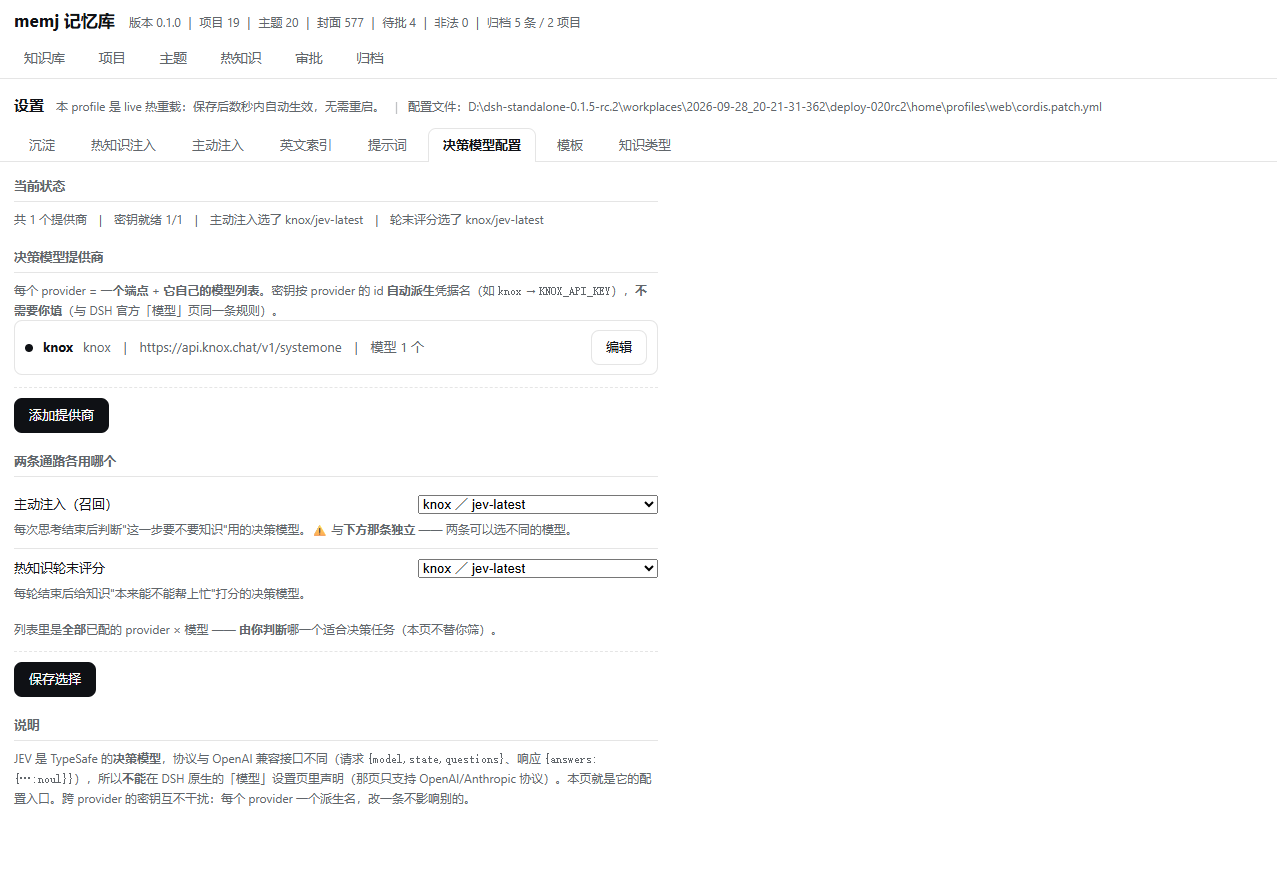
上图是其中的「决策模型配置」子页 —— 它管的是主动注入与轮末评分 这两条通路"用哪个模型来判"。
⭐ 为什么它必须单开一页:这类决策模型(如 JEV)的协议与 OpenAI 兼容接口不同
(走 /v1/systemone,请求 {model, state, questions}、响应 {answers: {...}}),
装不进 DSH 原生的「模型」设置页(那页只支持 OpenAI / Anthropic 协议)。
- 支持多 provider:每个 provider = 一个端点 + 它自己的模型列表;
- 密钥名按 provider id 派生(
knox→KNOX_API_KEY),不用你填; - 两条通路(主动注入 / 热知识轮末评分)各选各的,可以选不同模型;
- ⚠️ 密钥只写不回显 —— 页面上只显示"密钥就绪 N/M",不显示值;
- 每个 provider 的密钥互相独立,改一个不影响别的。
安装
插件是一个 DSH bundle(package.json 里声明了 dsh.bundle.patch)。
⚠️ 先确认 DSH 版本
本插件要求 DSH >=0.1.5-rc.2 <0.3.0(package.json 的 engines.dsh 与 peerDependencies 都写着)。
🔴 别直接按 latest 装 —— DSH 各包在 npm 上:
| dist-tag | 版本 | 能用吗 |
|---|---|---|
latest | 0.1.0-rc.6 | ❌ 太老 |
next | 0.2.0-rc.2 | ✅ 用这个 |
alpha | 0.2.1-alpha.2 | ✅ 也可以 |
⇒ 装 DSH 时带上 @next:
pnpm add @deepseek-ai/dsh-agent@next # 而不是 @latest
⭐ 一条命令自检(会打印你当前装的版本):
node -p "require('@deepseek-ai/dsh-tools/package.json').version"
常规安装(从 npm)
包页:https://www.npmjs.com/package/dsh-memj
dsh plugin --profile web add dsh-memj
也可以直接
pnpm add dsh-memj(等价;dsh plugin add多做的是下面那两步自动登记)。
一条命令就够 —— 它会:① 在 profile 目录里跑 pnpm 把它装进 dependencies;
② 发现包里声明了 dsh.bundle ⇒ 自动把 dsh-memj 加进 dsh.profile.bundles;
③ 立刻装载。
⭐ 实测(全新 home + 全新 profile + 真 tarball):
命令 exit 0,两条清单都自动写对了(不用手改 package.json、不用手建 junction);
⭐ 不重启就生效 —— 在正在运行的实例上装完,约 6 秒后侧边栏入口与
/plugins/dsh-memj/* 全部可用(进程启动时间未变,可证没有重启)。
更简单的,可以走 DSH 界面的插件管理页安装,同样不需要重启。
⚠️ profile 名按你自己的来:默认是 web,也可以是 tui / headless / 你自己建的。
⚠️ 升级时:请带上版本号
dsh plugin --profile web add dsh-memj@0.1.1 # ✅ 显式要这个版本
🔴 只写包名(add dsh-memj)可能把你留在旧版本:pnpm 会优先复用 profile 里
pnpm-lock.yaml 已经锁定的那个版本 —— 只要它满足 package.json 里的范围
(如 ^0.1.0),pnpm 就认为"已经装好了",不会去 npm 上看有没有新版。
⚠️ 这不是 npm 包或 GitHub 仓库的问题:全新环境(没有锁文件)装到的就是 latest;
只有装过旧版的机器会被自己的锁文件钉住。
(界面上安装时,在输入框里填 dsh-memj@<版本> 即可。)
⭐ 锁文件本身是好东西,别手动删:它还钉着 tarball 的 integrity 哈希(防同名同版本被换内容)。
从 GitHub 直接安装(不经过 npm)
包已提交 lib/ 构建产物 ⇒ 仓库可以直接装(不需要本地构建):
dsh plugin --profile web add https://github.com/jojoman2024/dsh-memj
⭐ 这也是本仓特意提交 lib/ 的原因 —— 生态里多数 DSH 插件仓都是这么做的。
⚠️ 但日常建议用 npm 那条:它有版本号可追溯,且 files 白名单保证了包内只含运行时需要的东西
(node_modules / scripts / src 之类不会被装进去)。
开发时安装(本地源码)
改源码时要 link:,这样跑的就是工作区里那份:
{
  "dependencies": { "dsh-memj": "link:D:/.../adapt-memj" },
  "dsh": { "profile": { "bundles": ["...", "dsh-memj"] } }
}
⚠️ 这条路上 dsh plugin ... add 那三步得自己做:node_modules 里建指向插件目录的
junction、bundles 数组里手工加一行。漏任一处都只是"没加载",不会报错。
cordis.patch.yml(随包发出去的那个)
🔴 dsh.bundle.patch 是必需的:package.json 声明了它,
缺文件会在 profile 加载期硬失败(dsh-app-boot 读 overlay 时直接抛)。
# cordis.patch.yml
- insert:
    - id: memj
      name: dsh-memj
⚠️ 它只管「把插件挂进 profile」这一件事 —— 这个插件host 与 client 两半都有
(工具/协议/命令/路由 在 host,侧边栏入口与 /memj-review 弹窗在 client),
而 client 的清单在 package.json 的 dsh.client 里,不在本文件。
⭐ id 是 memj,不是包名 dsh-memj ——
设置面板要往 profile 的 patch 里写 - id: <这个值> 的 config 覆盖,
写错 id 的后果极隐蔽:boot 时只打一行 patch: entry "dsh-memj" not found 警告,
配置静默不生效,而面板还显示"已保存"。
库长什么样
~/.dsh-memj/                        ← 整个库 = 一个目录,拷走即迁移
├─ projects/HANDOFF-<项目>.md       ← 项目文档:【唯一写入源头】(叙事 + 知识索引)
├─ entries/<slug>-<uuid8>.md        ← 知识全文(一条知识一个文档)
├─ themes/THEME-<id>.md             ← 主题层:派生(手改会被 rebuild 覆盖)
├─ GLOBAL.md                        ← 全局层:派生
├─ reads/session-<id>.jsonl         ← 读快照(跨项目证据)
├─ doc-reads/session-<id>.jsonl     ← 项目文档读记录
├─ recall-log/  score-log/          ← 两张追加型 jsonl 日志
├─ hot/                             ← 热知识:画像 / 逐条设置 / 逐项目清单 / 会话绑定 / 评分表
├─ tags/vocabulary.json             ← 标签词表
├─ prompts/overrides.json           ← ⭐ 提示词覆盖值(运行期唯一源头)
├─ templates/<id>.md                ← 项目文档模板
├─ kinds.md                         ← 知识类型词表
├─ nominations.json                 ← 待批 global 提名
├─ backup/                          ← 知识全文镜像 + 它自己的 git 仓库
├─ recall/en-index.json             ← 英文召回索引
└─ .startup-diag.txt                ← 启动诊断(排障第一手证据)
库根可用 MEMJ_DATA_DIR 覆盖(空白环境变量视为未设置)。
⚠️ 量库体积时 Get-ChildItem -Recurse 要加 -Force:
backup/.git/ 是隐藏目录,不加会静默跳过 ⇒ 得到一个偏小 43% 的数字。
三种数据的性质(务必分清)
| 纯投影(derived) | 积累的判断(source) | 用户数据 | |
|---|---|---|---|
| 例 | themes/ · GLOBAL.md · recall/en-index.json | tags/vocabulary.json · hot/scores.json | prompts/ · templates/ · kinds.md |
| 丢了 | 重建就有 | 🔴 永久丢失 | 手工重配 |
| 维护法 | 全量重建 + diff | ⚠️ 只能增量对账,绝不重建 | 随库迁移 |
🔴 最大的一处陷阱:给 tags/vocabulary.json 照抄 en-index 那套"重建"逻辑,
会静默抹掉所有积累的裁决——而且看起来像"修好了"(条数对、结构对,就是判断没了)。
配置
配置走 profile 的 cordis.patch.yml(- id: memj 那条的 config),
或者直接用人侧设置页改(写的是同一个文件)。
78 个配置键,按功能分 8 组:读取 / 沉淀 / 热知识 / 知识评分 / 英文索引 /
标签规范化 / 主动注入 / JEV。设置页每一项下面都有一行「保存后」说明它怎么生效
(✅ 立即生效(无需重启) 或 ⚠️ 需重启实例才生效)。
⚠️ 三个总开关默认关(hotInject / hotScoreOnTurnEnd / activeInject),
与 memj 的一贯姿态一致:插件不推、模型主动查,用户显式开启才注入。
关着的时候一个监听器都不挂(零开销,也不出现在事件链上),
诊断行会如实区分 xxx-registered 与 xxx-skipped(disabled)。
⚠️ 设置是按「版块」保存的,不是按页 —— 每个版块有自己的保存按钮与结果行。
决策模型(JEV)配置
JEV 不是 OpenAI 兼容协议(走 /v1/systemone),DSH 原生「模型」设置页装不下它
⇒ 本插件自带**「决策模型配置」子页**,支持多 provider,
密钥只写不回显(存进凭据 seam,界面上永远只显示"已配置")。
边界与已知限制
- 不做向量检索 / rerank:检索是整词
includes+ 权重累加(查询词由模型提炼)。 ⚠️ 因此不做二次切分(入缓这种无意义字串永远不会被凭空造出来)。 - 不做多实例隔离:一个库给全部实例用。⚠️ 多个实例同时评同一个项目时会丢更新 (评分表的互斥作用域是本进程)——单用户单实例下够用,已知边界。
- 不自动修复断链的外部引用:只报告 + 给人一个"重填路径"的入口,不猜路径。
- 不迁移工作区里现存的
HANDOFF-*.md。 - 主动注入是实验功能:效果与所选决策模型强相关,请自行摸索与调参。
- 库文件走
node:fs直接读写:插件自己的 API 依赖"本机回环 + 你自己开的端口", ⚠️ 不要把它暴露到公网。
开发
pnpm run build      # tsdown(host + client 两个条目)→ copy-web → 产物自检 → 提示词账本对账
pnpm run typecheck  # tsc(src) + tsc(src/client)
pnpm run test       # 52 个套件
pnpm run check      # 上面三合一
🔴 别自己拼构建命令行:tsdown.config.ts 导出的是数组(两个条目),
会打印两次 Build complete;用管道截断输出会杀掉上游进程
⇒ lib/ 里只剩 client.js。用 scripts/build.mjs,它把顺序写死并做产物自检。
⚠️ run-all-tests.mjs 用 spawnSync(stdio:'pipe'):在管道受限的环境下
(如某些沙箱)它会把全部套件报红且失败详情为空。那是环境问题、不是回归。
挂载与生效
| 改了什么 | 怎么生效 |
|---|---|
src/web/*(前端静态资源) | 刷新页面即可(每次请求现读磁盘) |
src/*.ts(host 半边) | 🔴 必须重启实例(启动时 import 完,之后不再读盘) |
| 【提示词】设置页里的任何文本 | 改完即生效(命令描述除外,那个要重启) |
cordis.patch.yml 的 config | 看 profile 的 patchReload:live ⇒ 热重载;startup ⇒ 要重启(没写 = live) |
⚠️ pnpm run build 之后必须重启才能让运行中的实例生效。
⭐ 改了前端刷新就变、只有 API 是旧的这种情况是有意为之(静态文件每次读盘),
别据此判断"构建已生效"。
实现要点(改代码前先读)
- 库的读写必须走
node:fs,不能用ctx.fs:后者受DSH_PERMISSION_MODE/sandboxPolicy管辖,默认workspace-write的可写根只有 workspace + tmp, 而库在~/.dsh-memj/⇒ 会被FS_SANDBOX_DENIED拒掉。 ctx.inject(['systemPrompt','tools','commands'], cb)缺任何一个服务, 回调就永不执行且无报错 —— 表现是"插件加载了但工具/命令一个都没有"。 所以启动诊断写进.startup-diag.txt。- 🔴
api.ts的路由必须在index.ts里逐个注册:漏一个 ⇒ 请求落到 SPA 兜底、 返回 HTML 而不是 JSON,前端JSON.parse报错,而服务端毫无异常。 - ⭐ 同一事实只能有一份实现:
paths/store/parse/prompts/sections/edit—— 任何新增的"第二条维护路径"都必须同时新增一条能报红的检查。 source.kind是plugin:dsh-memj(0.2.0 起没有 catch-allplugin了)。- 给模型写提示词时,绝不把运行时数字写进常驻文本(那会导致前缀缓存永不命中)。
- 🔴 改"看起来是 bug"的地方之前,先确认它不是"在替别的东西兜底" ——
实例:知识类型的
enum被{ ...kindParam(...) }展开求值成静态值, 看起来是"getter 失效";但它恰好满足了 DSH"参数必须是静态数据记录"的要求 ⇒ 按"修 bug"的思路加回 getter,4 个工具整条注册失败。 ⭐ 判据:"能注册上" ≠ "设计对了" —— 两者可能由同一个 bug 维持。
发布(给维护者)
pnpm publish # prepublishOnly = build + 发布闸门,两道都过才发得出去
🔴🔴 lib/ 是构建产物、被 .gitignore 排除,而 files 又必须列它 ——
这两条都对,错在它们之间没有守卫:
从 git 克隆出来的仓库里直接
npm pack,打出来的是个空壳包 (只有LICENSE/README.md/cordis.patch.yml/package.json,没有lib/), 而 npm 不报错 ——files里列了不存在的路径,它只是跳过。 ⚠️ 回执上 name / version / shasum 一应俱全,看起来完全正常。
⭐ 判据:要断言的是「产物」,不是「配置」。所以 scripts/check-pack.mjs
实测打包(npm pack --dry-run --json)再断言里面真有 lib/index.js / lib/client.js,
不看 files 字段;README 引用的截图也一并断言(否则 npm 上图全裂、GitHub 上却正常)。
它同时挂在 prepublishOnly 和测试套件里
(前者保证发布时必过,后者保证平时就能报红)。
License
MIT
Comments
Loading…
Similar plugins
by lpf20200901
给 AI 编码助手的跨会话长期记忆:自动注入、只推变化。DSH 插件 + 零依赖 CLI。
★ 0
MIT
JavaScript
Oct 1, 2026
dsh plugin --profile web add dsh-memory-deltaby ly028716
Intelligent memory system for DSH - Track user preferences, tool usage, and project context to provide personalized recommendations
★ 0
MIT
JavaScript
Sep 28, 2026
dsh plugin --profile web add @ly028716/dsh-memory-pluginby Fishsb
DSH 长期记忆插件:记忆库 + 会话蒸馏自动沉淀 + 设置面板,越用越懂你。守藏(Shoucang)单插件,panel + scheduler + 内嵌记忆技能。
★ 4
Apache-2.0
JavaScript
Sep 27, 2026
dsh plugin --profile web add dsh-shoucang-memoryby yj-liuzepeng
Persistent project intelligence and memory plugin for DSH: architecture analysis, cross-session context, TODOs, and optional hybrid retrieval
★ 101
↓ 36/wk
MIT
JavaScript
Oct 8, 2026
dsh plugin --profile web add dsh-project-brainby SiriusWJ
DSH 简化版记忆插件:SQLite 条目化记忆(标题/重要程度/来源/内容,增删改查)+ 日历与到点提醒(月视图+时间轴+待执行/已完成双tab),对话面板记忆 tab 与设置二级菜单,中英双语自动跟随。
★ 2
BSD-3-Clause
JavaScript
Sep 15, 2026
dsh plugin --profile web add dsh-lite-memoryby LittleBlackTong
Long-term cross-session markdown memory with an LLM-Wiki structure and a SOUL.md persona, injected at session start (by default only after the first user message and only in the active session), plus
★ 4
↓ 348/wk
MIT
JavaScript
Oct 8, 2026
dsh plugin --profile web add dsh-plugin-memory