
dsh-ai-output-trust
Manifest validAI Output Trust Boundary: Check whether the code directly executes AI output (eval/shell/SQL/path).
@deepwhale-cn/dsh-ai-output-trust

关键词:AI 输出 · AI 安全 · 提示注入 · 提示词注入 · 大模型安全 · 任意代码执行 · LLM 安全 · 大模型 Keywords: AI output trust · prompt injection · LLM security · code execution · OWASP LLM AI 输出信任边界 —— 检查代码有没有直接执行 AI 输出。
不装它会怎样
你的 agent 里有这么一行:
eval(aiResponse);
想法是「让模型生成一小段脚本,我执行它」。
但 AI 输出是不可信输入 —— 它可能被提示注入控制,也可能自己发挥。 你等于把任意代码执行权交给了一个概率模型。
OWASP 把这单列为 LLM05 Improper Output Handling。
它查什么
| 级别 | 内容 |
|---|---|
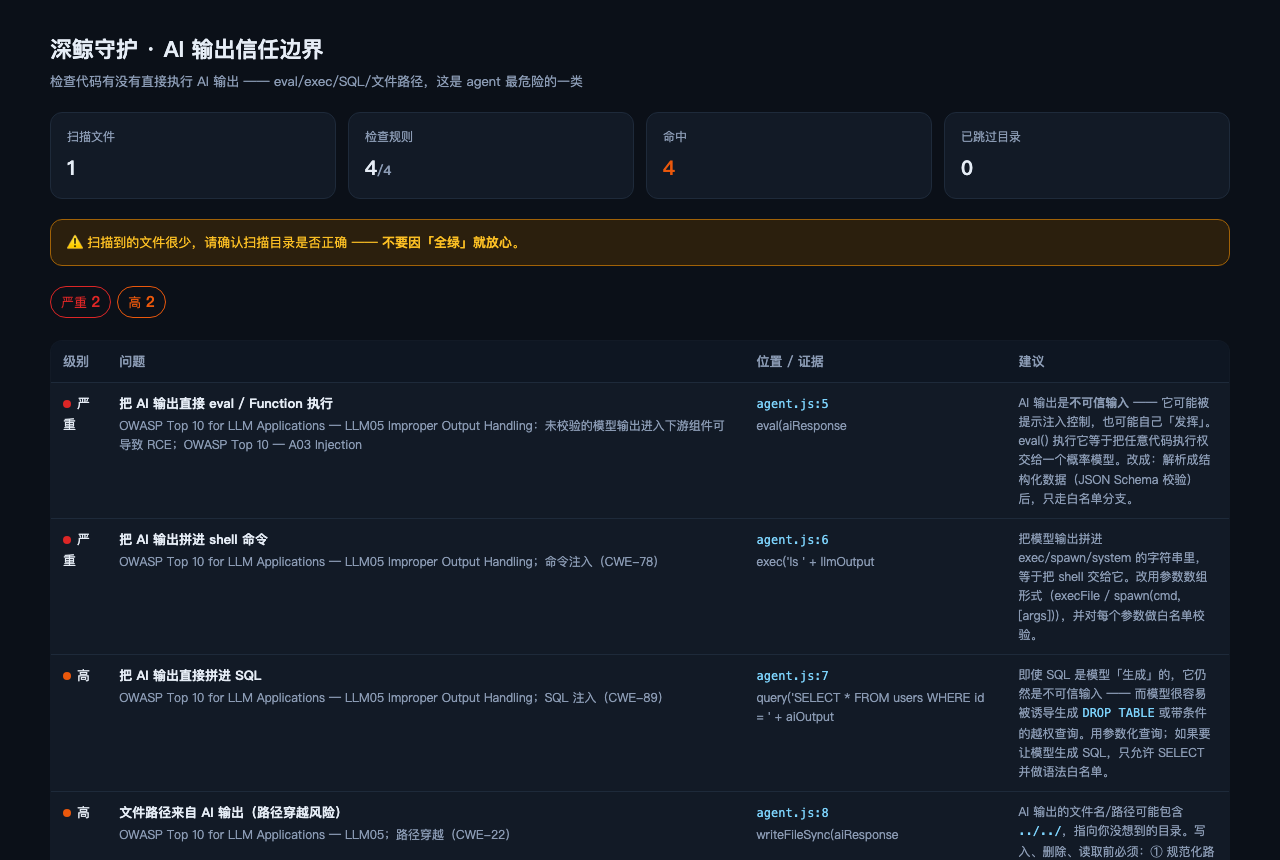
| 🔴 严重 | eval(aiResponse) / new Function(...) |
| 🔴 严重 | AI 输出拼进 exec / spawn |
| 🟠 高 | AI 输出拼进 SQL |
| 🟠 高 | 文件路径来自 AI 输出(路径穿越) |
它不会误报「只是调了模型」
变量识别用精确命名,不是「看到 .content 就报」。
这段不报(调了模型,但当成不可信输入处理):
const raw = result.choices[0].message.content;
const parsed = safeJsonParse(raw);
if (!schema.validate(parsed)) throw new Error('invalid');
这段报:
eval(aiResponse);
正确的做法
AI 输出 → 结构化解析 → Schema 校验 → 白名单分支
        → 参数化查询
        → 路径规范化 + 断言在允许根目录内
安装
dsh plugin --profile web add @deepwhale-cn/dsh-ai-output-trust
# 或纯 CLI
npx @deepwhale-cn/dsh-ai-output-trust
用法
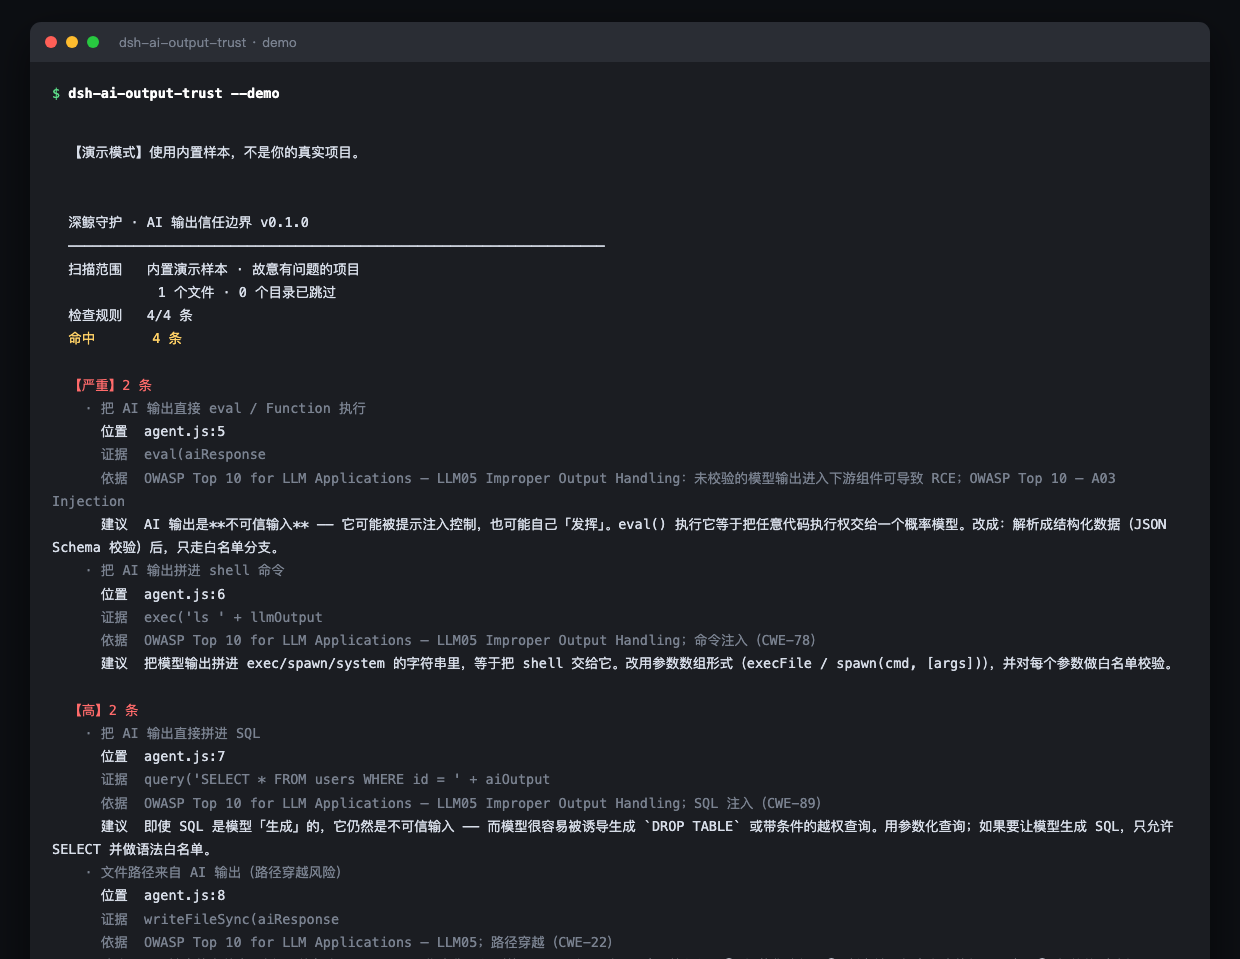
dsh-ai-output-trust --demo          # 看检出效果
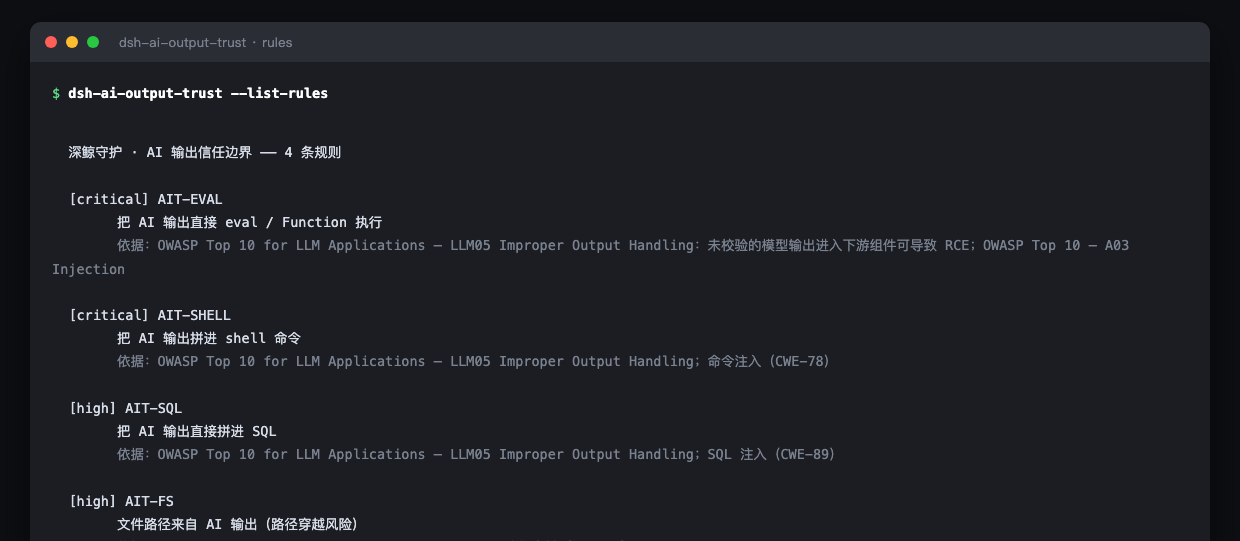
dsh-ai-output-trust --list-rules    # 列出规则和依据
dsh-ai-output-trust --html r.html
边界
- 只查四种明确的高危用法(eval / shell / SQL / 路径)。其它「间接信任」不在范围。
- 靠变量命名识别 —— 建议统一命名(
ai*/llm*/model*),否则会漏。 - 不做数据流分析,只看调用点附近。
- 与 dsh-ci-guard 分工:那个查 GitHub Actions 脚本注入,这个查运行时。
本插件是一个工具。使用者必须遵守所在地区法律法规,对使用本项目造成的任何后果自行承担责任。
深鲸网安守护系列(共 22 个)
一个插件做一件事。安全问题是链式的 —— 配套用才完整。
国内合规 | 等保对照 · 日志留存 · 备案公示 · 用户同意 · 个人信息权利 · 未成年人保护 · 影响评估 · 数据分类分级 · 算法备案 · 数据出境
AI 与 Agent 治理 | AI 输出信任 · 外部内容信任 · MCP 安全 · Agent 权限
都在 DSH 插件市场(dsh-plugin.org)和 npm 上,dsh plugin --profile web add <包名> 即可安装。
License
MIT © 深鲸 DeepWhale
Comments
Loading…