
dsh-video-storyboard-hp
IdentifiedHigh-performance fork of SAOS-3624/dsh-video-storyboard — install this or the upstream plugin, not both. Turns a video into addressable storyboard grids (numbered cells, a timestamp and transcript lin
dsh-video-storyboard-hp · 高性能版

给纯文本模型装一双「能翻页的眼睛」。(DeepSeek Harness 视频分镜插件 · 高性能版)
English: README.en.md
上游原作: SAOS-3624/dsh-video-storyboard(MIT)
本仓库: DSH-Raising-Plan/dsh-video-storyboard-hp · 默认分支feature/high-performance
社区衍生,与 DeepSeek / 原作者均无官方隶属关系。
输入一个视频,输出一张可寻址的宫格图:每格烧着编号、对应一段时间、下面挂着那段时间里说过的台词;底部还有一条与画面同时间轴的音频包络。模型因此可以「看」、可以「引用第 5 格」、可以「再放大看这 3 秒」,而不是被动接受一段别人写好的摘要。
效果(实测数字):5 分钟片子 → 一张图,9–16 帧只花 384 token;逐帧方案同样覆盖要 3,072–6,144。
90 秒 PV 扫描 9 秒,出 12 格、对齐 41 个切点。同一文件第二次调用 3.6 秒(命中缓存)。
不需要模型权重、不需要图像库、不需要字体配置。
与原作者版本的区别
本仓库基于上游 fork,在 feature/high-performance 上演进(不是与上游 main 逐提交同步)。对外工具名不变:video_probe / video_storyboard / video_zoom。相对 SAOS-3624/dsh-video-storyboard 的主要增量:
| 方面 | 本仓库(高性能版) | 上游常见路径 |
|---|---|---|
| 架构 | VAA 三阶段:analyzeVideo → planStoryboard → renderStoryboard;zoom / batch / textOnly 可复用分析 | 偏一体式管线 |
| 选格 | 默认 coverage(切点+音频+台词+均匀 → 时间桶覆盖 + 显著性);保留 density;aHash 去近重复 | 以密度积分为主 |
| 长片 | ≥1h(或 sampleAbove)采样扫镜头(每 5 分钟扫 30 秒),degraded / unscanned_gaps | 全量扫描成本更高 |
| 快剪 | manifest fast cuts: 标出最密区间并建议 video_zoom({ minGap: 0.4 }) | 无专用提示行 |
| 记忆 | seen.jsonl:分析过的窗口可被 video_probe 回放,避免重复描述 | 无 |
| 扫描诚实性 | 严格阈值 + 截断、色相环形比较、连续运镜标 degraded: motion | 实现细节不同 |
| 可选增强 | enrichment sidecar(远端切点 / 说话人等,默认关) | 视上游版本而定 |
安装(装到本机 DSH):
dsh plugin --profile web add github:DSH-Raising-Plan/dsh-video-storyboard-hp#feature/high-performance
本地试跑:
git clone -b feature/high-performance https://github.com/DSH-Raising-Plan/dsh-video-storyboard-hp.git
cd dsh-video-storyboard-hp
npm test
node bin/storyboard.mjs your-video.mp4 --cells 9 --text
需要: Node ≥ 20,ffmpeg / ffprobe 在 PATH。
设计原点(三句话,定了大半架构)
| 你的直觉 | 落到代码里 |
|---|---|
| 「先看台词,再决定怎么分」 | 音频与台词在格数决策之前算完;字/秒作为第三条密度信号参与格位分配——话密的地方格短。注意精确说法是"先拿到台词再决定每格覆盖多久",切换点本身仍是画面信号 |
| 「取帧要挑最清晰的,别被模糊转场坑」 | 段内取 3 个候选,比 Laplacian 方差取最锐。ffmpeg thumbnail 按直方图挑帧,而模糊不改变直方图——它会心安理得地选中一张糊掉的人员表 |
| 「快闪的地方要多给格,但别让半秒镜头吃掉一整格」 | 快切区格短帧多;minGap 不只固定 1.2 秒,还会被素材自身粒度压住(不超过中位段长的 0.9 倍),否则六个 1 秒镜头会被并成三个、凑不够格数 |
算法做了什么(8 条,每条都是被真实素材打脸后改的)
| # | 做法 | 为什么不用那个更简单的做法 | 代码 |
|---|---|---|---|
| 1 | HSV 三通道差做场景切换检测(64×36,|ΔH|+|ΔS|+|ΔV| 取均值) | 只看亮度会漏掉"同亮度换色"的切点(测试片 9 个切点里 2 个是这种;ffmpeg scdet 找到 4/9,我们 9/9) | src/scan.js |
| 2 | 阈值按"速率"反推:目标约 1.5 秒一个切点,分数下限 12 | 3×p95 在 B-roll 上给 38(正常),在快剪动画上给 130 → 一个切点都没有,正好死在最需要多格的内容上 | src/scan.js |
| 3 | 格位 = 局部剪辑率积分的等分点,并吸附到真实剪辑点(位移 ≤ 理想格长 30%) | 均匀切会给"6 秒 20 刀"和"20 秒空镜"一样的空间;不设位移上限的吸附会把权重整个打乱 | src/density.js |
| 4 | 格数由画面运动 p90 决定,不由时长决定 | 静态单镜头给 16 格 = 16 张一样的图;PV 给 4 格 = 什么都没看清 | src/plan.js |
| 5 | 最小间隔不超过素材自身粒度(min(minGap, 中位段长×0.9)) | 固定 1.2 秒会把六个 1 秒镜头并成三个,然后就再也凑不够格数 | src/segments.js |
| 6 | 段内取最锐的一帧:3 个候选比 Laplacian 方差 | thumbnail=n= 按直方图挑帧,而模糊不改变直方图——它会心安理得地选中一张糊掉的人员表 | src/sheet.js |
| 7 | 音频包络画在同一条时间轴上,塞进同一张图 | 单独出一张音频图要多花 384 token,还丢了对齐——而对齐才是全部意义 | src/audio.js、src/sheet.js |
| 8 | ASR 按 ≤45 秒切片、切点落在静音中点,非语音段过滤并报出 | 299 秒单请求会把时间码整体压早 13 秒;纯音乐 PV 会吐出一条 29 秒的假台词、被贴到 5 个格子上 | src/asr.js、src/pipeline.js |
前人的工作、我们不打算超越的精度上限、以及刻意没做的事:docs/REFERENCES.md。
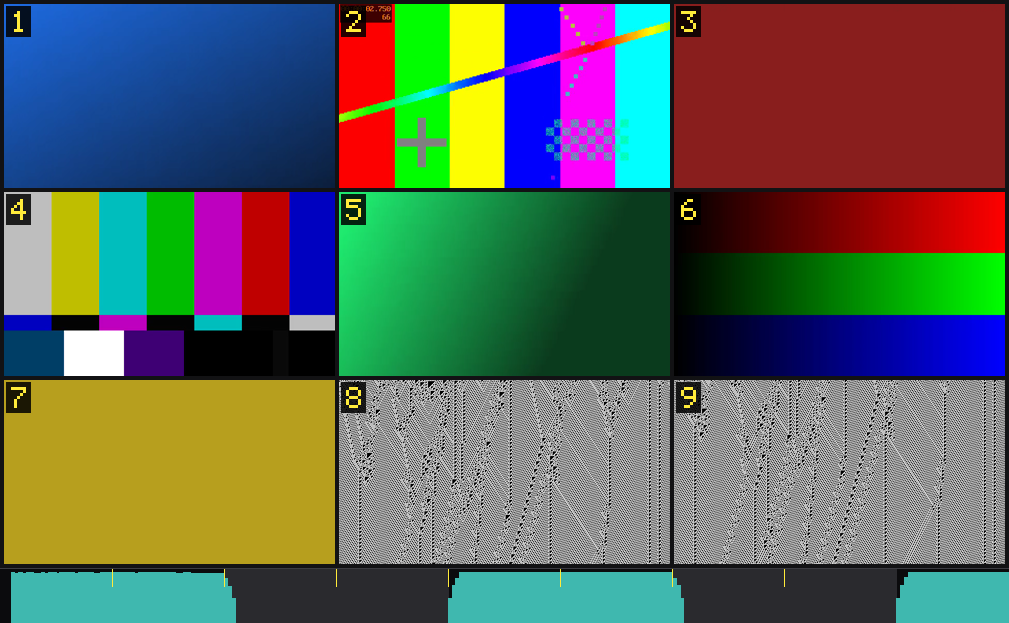
上图是它自己的输出:一段 27 秒的合成素材(9 个镜头、响—静—响的音频)→ 一张 9 格图 + 底部音频条带。 素材由 ffmpeg 现场生成,仓库里没有任何第三方视频画面。
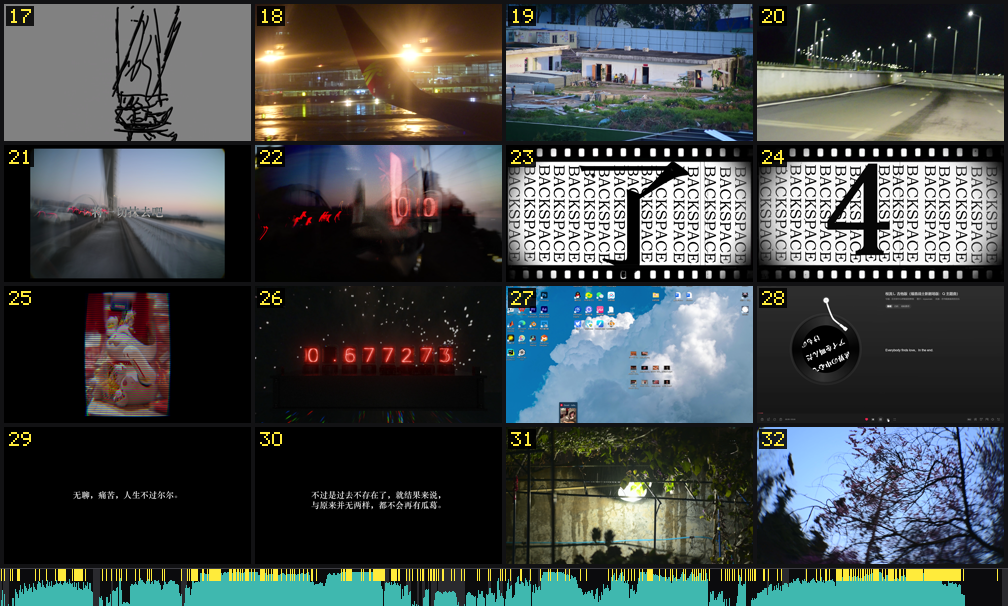
同一工具跑作者自己的 19 分钟视频:64 格分 4 张,这里展示第 17–32 格。底部黄线是片子里检出的切点。 这张图是作者本人的素材,仅作演示用途——见 NOTICE。
先澄清一个常见误解
市面上不少介绍会把这类工具说成"画面越乱分辨率越低"。本插件不是这样做的,而且刻意没这么做:
- 格子尺寸全都一样。快速剪辑的段落得到的是更短的时段(所以有更多帧),不是更小的格子。
- 原因是 token 账:一张图 384 token 是固定的,把格子缩小一半,模型看到的就是糊的——省不到钱,只丢信息。
- 时间轴全覆盖,但不保证每个镜头都被看到(5 分钟 300 个镜头塞进 16 格,物理上不可能)。要细节用
video_zoom。 - 连续运镜(快速摇镜、变焦)不是切点。任何帧差打分器(本工具、
scdet、TransNetV2)都会给它高分,所以要做峰值抑制与碎段合并。
长片:文本清单也是有预算的
一张图 384 token,但文本清单是没有上限的——一部 2 小时 35 分的片子出 64 个 cell,清单 75 KB, 超过宿主单次工具结果的上限,超出部分被折进磁盘上的溢出文件,模型没去读,于是中段 44 分钟的台词等于没给。 现在三件事堵住这个口子:
- 每格台词封顶,三档:
detail: low60 /med120(默认)/high400 字符,且截断落在句末 (120 字的预算会停在窗口内最后一个「。」之后,而不是切在半句)。实测 9 格:1,521 / 1,915 / 3,031 字符; - 在 cell 边界截断,并写明怎么续读:
[text stopped at cell 13 of 64 — call again with cellRange: [14, 64] and textOnly: true to read the rest] cellRange+textOnly:翻页取文本,不重出图、不重解帧。
video_storyboard({ input, cells: 16, sheets: 4 })                     // 4 张图 + 第一页文本
video_storyboard({ input, cells: 16, sheets: 4, cellRange: [14, 42], textOnly: true })
video_storyboard({ input, cells: 16, sheets: 4, cellRange: [43, 64], textOnly: true })
textOnly 不返回图,所以翻页不花 token;扫描与 ASR 结果都缓存后,每页约 0.8 秒。
整片批处理(命令行)——一部两小时的片子要 24 个窗口,手敲 24 次 --from/--to 不叫工作流:
node bin/storyboard.mjs film.mp4 --batch 300 --out film.png
# → film-w01.png … film-w24.png,外加 film-timeline.md
#   (窗口 | 格数 | 切点 | 字数 | 图片路径,一张表串成整条时间线)
尾巴短于 30 秒的窗口会并进前一个,而不是花 384 token 换一张只有 1 格的 2 秒图。
窗口边界会吸附到真实剪辑点(先全片扫一遍,--no-snap 可关),所以不会正好切在一句话中间。
一、它到底解决了什么问题
纯文本模型看不到视频。现有三条路各有硬伤:
| 做法 | 硬伤 |
|---|---|
| 抽 N 帧、N 张图发给模型 | 每张图 384 token,16 帧就是 6144。想看全片就破产 |
| 把帧发给外部视觉模型,回一段文字 | 回来的是别人替你看过的结论,不能追问、不能引用 |
| 只读字幕/ASR | 画面全丢。「这个镜头为什么好」这类问题永远答不了 |
我们走第四条:把 N 帧打进一张图。于是 384 token 就能看 9–16 帧,而且看的是当前这个模型自己。
二、六个真正不一样的地方
1. 打包,而不是逐帧 —— 同覆盖率下省 8–16 倍
| 方案 | 帧数 | 图数 | token |
|---|---|---|---|
| 本插件(9 格) | 9 | 1 | 384 |
| 本插件(16 格) | 16 | 1 | 384 |
逐帧插件 count=8 | 8 | 8 | 3,072 |
逐帧插件 count=64 | 64 | 64 | 24,576 |
代价是每帧分辨率:本插件一格约 68k 像素,逐帧方案每张可到 640k。这不是缺陷,是分工——先把"看多少帧"和"每帧多清楚"解耦,粗看用前者,细节用后者。
2. 可寻址 —— 编号烧进像素,不是排在文本里
三重冗余,任何一层失效都还能定位:烧进像素的编号(格高 15%)/文本坐标 cell 5 (r2c2, image 1)/精确时间码 frame@00:01:17.20。
为什么非烧进去:小模型数格子会数错(4×4 就开始飘),但读一个数字很准。做过下采样验证——整图降到每格 66×37,11% 格高的数字仍可辨认。
3. 选段:格位按内容密度分配,不是均匀切
均匀采样的隐蔽错误:20 秒的空镜和"6 秒里切了 20 刀"的高潮,拿到的格数一样,后者 19 个画面直接消失。
我们用三条信号叠出一条密度曲线,再在积分上等分:
| 信号 | 来源 | 作用 |
|---|---|---|
| 剪辑密度 | 局部切点率 / 全片平均率 | 快切区格短、帧多 |
| 台词密度 | 字/秒 | 话密的地方格短 |
| 声音事件 | 响度突变(+8 dB / −15 dB) | 画面没动但有事发生——突然安静、爆笑、音乐进副歌 |
第三条是帧差永远看不见的:口播片 299 秒里会触发 92 次(每句话的停顿),所以只在"话不密"的片子里启用;音乐 PV 只触发 7 次,正好是拍点。
4. 两段式:粗看 → 回看(video_zoom)
一张图 384 token 是固定的,所以清晰度和覆盖率零和。我们不硬凑,而是拆成两次:
第一次:9–16 格看结构(384 token)
第二次:对感兴趣的 3 秒调 video_zoom(384 token,格子大 4 倍)
回看时还能进一步调:
minGap: 0.4—— 把最小间隔从默认 1.2 秒压到 0.4,半秒的镜头也各得一格cells: 4~6—— 少格大图,字幕、人脸、画面里的字都能读
5. 选帧:比 Laplacian 方差,而不是取中点
段内取 3 个候选,选锐度最高的那帧。为什么不能省:
| 策略 | 问题 |
|---|---|
| 取段中点 | 溶解/淡入的中点拿到叠影 |
ffmpeg thumbnail | 按直方图挑帧,而模糊不改变直方图——它会心安理得地选中一张糊掉的人员表 |
| Laplacian 方差 | 无 |
真实案例:某 PV 片尾人员表,thumb 在 84.88s 拿到高斯模糊帧(文字全糊),sharp 在 85.20s 拿到清晰帧。同一个秒级窗口。
反直觉的是它更快:三次 seek 各解 1 帧 ≈ 9.2s,而 thumbnail 要解码整段统计直方图 ≈ 11.3s。
6. 快闪蒙太奇:告诉模型"切点在哪、切得有多快"
三件事同时给:
| 给什么 | 长什么样 | 回答什么问题 |
|---|---|---|
| 位置 | 底部条带上的黄色刻度 | 在哪切的 |
| 数量 | 每格 cuts 7、表头 cuts="141 (avg 2.1s)" | 这段切得多快 |
| 可调粒度 | video_zoom({minGap: 0.4}) | 觉得切太粗,能重切 |
没有第二项时,刻度线一密,模型只能"感觉"很密、数不准;有了数字,"这是快闪蒙太奇"才是个可陈述的事实。
三、读法有两种,其中一种会剧透
一部两小时片子的总览图,会把片尾的画面和片头摆在同一屏上。这对"这是部什么片"很有用, 对"接下来发生什么"是致命的。
| 它做什么 | 什么时候用 | |
|---|---|---|
结构读法 —— 全片 cells:16, sheets:4 | 4 张图,一次看完整条弧线;2.5 小时约 310 秒 CPU | 分析、索引、"值不值得看" |
顺序读法 —— from/to 窗口,一次 2–5 分钟 | 永远只看到你问到的那一段,后面的不会提前出现 | 追剧情、看悬念、逐镜头研究 |
video_probe 会把两种读法都列出来并标注哪种会剧透,不替你选。
工具里没有任何一处强制"先看全片":from/to 是主接口;每段的扫描结果都会缓存,
所以第一遍读过之后,回头再看某一段是免费的。
四、长片的成本模型
读一部 2 小时 35 分的电影,不是"24 张图一次性铺开"(= 9216 token)。正确读法是分两级:
| 阶段 | 花什么 | 拿到什么 |
|---|---|---|
① video_probe | 0 | 时长、有无音轨/字幕、建议怎么读 |
| ② 一次总览(16 格盖全片) | 384 | 结构:哪几段值得细看(7.5 分钟/格) |
| ③ 只打开可疑的 3 个段落 | 3 × 384 | 每段 16 格细节 |
| 合计 | 1536 | 和"一次性 4 张图"同价,但前 384 就能开始判断 |
差别不在总价,在决策顺序:旧做法先付 1536 再看,新做法付 384 就知道该不该继续。给模型省钱的方式不是压缩单张图,而是让它早一点停止。
五、实现原理
整条链是一次解码、多路复用:扫描时只解码到 64×36,把切点、密度、音频、台词全部拿到,最后只为选中的格子各解 1–3 帧。
1. 探测
ffprobe 拿时长/帧率/旋转/音轨/字幕轨。两个细节:手机竖拍会带旋转元数据,要按显示方向算宽高比;片尾常有一帧黑场,取帧时避开最后一帧。
2. 切分:HSV 三通道差 + 速率法定阈值
把每帧缩到 64×36(2304 像素),转 HSV,与上一帧逐像素求 (|ΔH|+|ΔS|+|ΔV|)/3。选 HSV 而不是亮度差,是因为同亮度换色(红→蓝)在亮度域几乎为零:测试片里 9 个切点有 2 个是这种,ffmpeg -vf scdet 只找到 4/9,我们 9/9。
阈值不是固定值,也不是分数的倍数,而是按速率反推:
目标切点数 = min(帧数 × 25%, 时长 / gap)      // gap ≈ 1.5s,短片收紧到 0.5s
阈值 = 分数排序第 (帧数 - 目标) 位,向下取整,且 ≥ 12
这条是被真实素材打脸后改的:第一版用 3 × p95,在 B-roll 上很准(38 分 → 88 切点),但在快剪动画上 p95 已经是 43,×3 = 130 → 0 个切点。越是需要多格的内容,倍数法越失效。
3. 分格:密度积分等分 + 吸附剪辑点
先按 0.1s 粒度建密度曲线(局部率要箱型平滑一遍,否则节奏均匀的片子会在每个切点附近鼓包、认出一堆假爆发),累积后按 总积分/格数 等分。切点会尝试吸附到真实剪辑点,但位移超过理想格长的 30% 就放弃——否则吸附会把权重分配整个打乱(踩过:全片被拉到剪辑点上,格长变得不均)。
4. 取帧:段内 3 候选,比 Laplacian 方差
| 策略 | 做法 | 问题 |
|---|---|---|
mid | 取段中点 | 溶解/淡入的中点拿到叠影 |
thumb | thumbnail=n= 取直方图最接近均值的帧 | 对模糊→清晰不敏感(模糊不改颜色分布) |
sharp(默认) | 段内 3 个候选,比 Laplacian 方差取最大 | 无 |
真实案例:某 PV 的片尾人员表,thumb 在 84.88s 取到的是高斯模糊帧(文字全糊),sharp 在 85.20s 取到清晰帧——同一段、同一秒级窗口。
反直觉的性能结果:90s 片 / 9 格,mid 8.0s、sharp 9.2s、thumb 11.3s。锐度法比 thumbnail 还快,因为三次 seek 各解 1 帧,而 thumbnail 要解码整段才能统计直方图。
5. 拼图:零图像库、零字体依赖
取帧直接解成 rgb24,按 cell 尺寸做 cover 裁剪;宫格在普通 Buffer 上逐字节拼;编号用内置 5×7 点阵字模画;最后 -f rawvideo -pix_fmt rgb24 喂回 ffmpeg 出 PNG(或 -f image2pipe 直接给宿主)。
这一套把 Pillow / sharp / canvas / fontconfig 全部移出依赖图。最后那个不是洁癖:drawtext 需要字体系统,而 Windows 上的 fontconfig 经常是坏的——测试机上跑 ffmpeg -vf drawtext 直接报 Cannot load default config file。零字体依赖等于零这类事故。
6. 音频:条带与画面同轴
ebur128 抽瞬时响度(100ms/点)+ silencedetect 找停顿,然后画在宫格底部:青色柱是响度、深灰块是静音、黄色刻度是切点。
价值不在"能测响度",而在同一条时间轴:模型能把"第 5 格"和"这里最响"直接对上,不用自己做时间映射。成本是同一张图内 0 额外 token,只占约 9% 像素预算。
它回答"哪里在响",不回答"为什么响"。实测一支成片的响度全程只在 3 dB 内波动、与剪辑数相关 r=0.35——母带处理把动态压平了,靠响度找不出副歌。
7. 台词:三级降级 + 切片 + 幻觉过滤
字幕轨(免费、最准)→ OpenAI 兼容 ASR(本地/云)→ 都没有就跳过(分镜照出)
三个坑,都踩过:
| 坑 | 现象 | 处理 |
|---|---|---|
| 长请求漂移 | 单次 299s 请求,时间码整体压早 13s(≈4.5%,停顿被吃掉) | 客户端切 ≤45s,漂移降到 0.02s |
| 切片劈词 | 固定秒数切会把词切两半,段数凭空变多 | 切点吸附到静音中点 |
| 音乐段幻觉 | 纯音乐段吐出 29s / 9 字的假句子,按时间重叠被贴到 5 个格子上 | 时长 > 8s 且 < 0.8 字/秒 判为幻觉丢弃,并在输出里报出丢弃条数(不静默丢) |
台词最后按时间重叠贴到格子上——一句跨两格时两边都保留,宁可重复也不让某格"没话说"。字/秒还作为第三条密度信号喂回去:话多的地方格更短。
8. 缓存
键 = (路径, 大小, mtime, 窗口, 阈值策略)。不 hash 文件内容(2GB 读一遍比重新扫描还慢),不缓存响度(2 小时有 7 万个点)。实测 5 分钟片子:首次 13.4s → 第二次 3.6s。这样 video_storyboard 之后再 video_zoom,同一段不会扫两遍。
六、为什么是这些取舍
384 token/图 是硬约束,所以「格数」和「每格清晰度」是零和的。整个设计围绕一件事:把一次性的"看"拆成两段——先粗看结构,再按需放大。
| 需求 | 做法 |
|---|---|
| 这片子讲了什么 | 9–16 格概览(384) |
| 第 1:12 发生了什么 | video_zoom(from, to)(384) |
| 一句台词在哪一格 | 清单直接给 cell k = 时间码 |
| 音乐什么时候起来 | 底部条带(0 额外) |
| 一小时的电影怎么看 | --plan 300 分段,逐段 --from/--to |
七、实测基线
6 条 1080p 素材(B-roll / 动画正片 / 两支 PV / 特别 ED / 单镜头长take):
| 素材 | 时长 | p90 | 自动阈值 | 切点 | 平均间隔 | 自动格数 |
|---|---|---|---|---|---|---|
| B-roll | 299s | 7.9 | 16 | 141 | 2.1s | 16×1 |
| 动画正片 | 1090s | 15.0 | 43 | 408 | 2.7s | 16×2 |
| 特别 ED | 80s | 11.6 | 21 | 42 | 1.9s | 4×1 |
| PV(正式) | 92s | 17.0 | 54 | 44 | 2.1s | 9×1 |
| PV(概念) | 90s | 26.1 | 58 | 41 | 2.2s | 9×1 |
| 单镜头 | 251s | 2.2 | 12 | 1 | — | 4×1 |
扫描速度:22–47× 实时(1080p,瓶颈是 H.264 解码,不是打分)。
台词密度还能反过来当类型判据(响度与字/秒反向):
| 类型 | 字/秒 | 响度 |
|---|---|---|
| 口播教程 | 5.60 | −23 LUFS |
| 叙事动画 | 2.07 | −21.4 LUFS |
| 音乐 PV | 0.32 | −14.2 LUFS |
字/秒 < 0.8 且响度 > −18 基本可以判定"音乐驱动,别指望台词"。
八、边界:明确不做的事
- 不保证每个镜头都被看到,只保证时间轴不漏。
- 不做音乐理解。响度是测量,不是理解;情绪、曲风、副歌位置都不在范围内。
- 手机端未实测(设计上零原生依赖,Termux 理论可行)。
- 超长视频解码是瓶颈:2 小时片子首次约 5 分钟,降采样实测无收益(瓶颈在解码不在打分)。
九、架构与后续(本仓库已落地)
V2 架构见 docs/ARCHITECTURE.zh.md:VAA → plan → render;覆盖选帧;zoom 切片复用;Memory episode。
| 能力 | 状态 |
|---|---|
video_probe / 结构读法·顺序读法 | ✅ |
| VAA 分析资产 + 进程内复用 | ✅ |
| coverage 选格 + aHash 指纹 | ✅ |
| 长片采样扫描 + cache LRU | ✅ |
fast cuts: / seen.jsonl | ✅ |
textOnly / cellRange / detail | ✅ |
| 可选 enrichment sidecar | ✅(默认关) |
| episode 适配器 | ✅ |
仍可加强
- 更强的说话人分离与事件理解(enrichment 侧)
- npm 正式发布 / 多语言验证 / Termux 实测
- 与上游
main的定期 rebase(当前刻意独立演进)
十、和其他视频插件怎么选
只想"看一眼这几帧"                → 逐帧类插件(更简单、无需全片扫描)
想让别的模型替我总结成一段话       → 桥接类插件(外部 VLM)
想知道"整片怎么组织、第几分钟发生了什么、谁在说什么"
                                 → 本插件(video_storyboard + video_zoom)
只想分析一首歌                     → 音乐分析类插件
许可
MIT。上游版权归 SAOS-3624 及相关贡献者;本仓库在其基础上继续修改。不复制任何第三方源码;ffmpeg、模型权重、视频素材都不随仓库分发。ASR 默认对接用户自建的 OpenAI 兼容端点(如 SenseVoiceSmall,FunAudioLLM / 阿里,遵循 FunASR Model License v1.1,保留署名)。
Comments
Loading…
Similar plugins
by simikangtao
End-of-chat visual storyboard: a storyboard tool renders a self-contained HTML card (inline SVG diagram, numbered flow, facts grid, timeline) from a JSON spec, writes it under ~/.dsh/storyboard/<sessi
★ 0
JavaScript
Sep 14, 2026
dsh plugin --profile web add dsh-storyboardby NINKCH
A node-based short-drama studio inside DeepSeek Harness. Start from a one-line idea, walk out with a storyboarded, voiced, subtitled video cut — right on an infinite canvas.
★ 4
↓ 1.9k/wk
Apache-2.0
JavaScript
Oct 30, 2026
dsh plugin --profile web add @ninkch/dsh-infinite-canvasby q253595422
DeepSeek Harness plugin: image + video generation studio with an infinite canvas. Fork of dickpy/dsh-imagegen with a complete video pipeline and clip stitching.
★ 66
↓ 2.4k/wk
Apache-2.0
TypeScript
Oct 30, 2026
dsh plugin --profile web add @q253595422/dsh-imagegen-videoby OrderG-X
Inline video and audio playback inside DeepSeek Harness: a play_video tool plus a native player at the turn tail, served by a signed Range-capable streaming route.
★ 2
↓ 295/wk
MIT
JavaScript
Oct 27, 2026
dsh plugin --profile web add dsh-video-previewTikTok-style video feed in a floating sidebar window: swipe local or SMB-NAS folders, or paste online video URLs (yt-dlp, bilibili/YouTube, cookies.txt login state); the window auto-fits the video asp
★ 0
dsh plugin --profile web add dsh-plugin-video-playerby zemul
dsh-better-sidebar 的视频文件预览插件: 在侧边栏打开 .mp4 .webm .mov .mkv .avi 等视频文件时,内联渲染一个可播放、可拖拽进度条的 <video> 播放器。
★ 8
↓ 402/wk
MIT
JavaScript
Aug 27, 2026
dsh plugin --profile web add dsh-video-preview