

dsh-mnemosyne
Manifest valid★ 10Mnemosyne 2.0:个人认知基础设施;DSH 插件适配层 + 独立 Python Node / Memory Bank。
Mnemosyne 2.0
2026-11-01:按重构理论补全证据依赖、反馈隔离、有界任务与独立验收后的规则采用/回滚。接口、兼容变化和验证范围见 理论实现报告。
本轮修复了权限、Verified、Claim 身份、迁移审批和 Trace 等审查问题,并新增本地接入/迁移闭环。实际验收与尚未完成的长期目标见 实现补全报告。
Modular Evolving Memory Infrastructure for AI Agents
让 Agent 不只是记住过去,而是能够理解变化、积累经验,并修正自己。
Mnemosyne 是一个面向 AI Agent 的模块化记忆基础设施。
它不排斥其他记忆系统,而是成为个人认知的权威层(Cognitive Authority Layer),通过适配器与其他记忆库协作。
它为 AI Agent 和其他智能应用提供一套独立、持久、可治理、可演化的认知能力,让它们能够积累经验、形成记忆、理解关系、检索过去、修正认知,并在时间中持续学习。
2.0 统一版: 本仓
canyueY/dsh-mnemosyne是 Mnemosyne 2.0 的唯一权威仓。 历史: 原canyueY/mnemosyne已归档,只保留历史,不再作为新版本入口。 本仓结构:service/= Node / Core / Python Memory Service;根目录src/+package.json= DSH 插件适配层;legacy/dsh-plugin/= 0.2 旧插件归档。 基线、GA 与完整文档见service/docs/REPO_BASELINE.md。
关键边界:一个 Node 一个 Memory Bank;
mnemosyne-memory-bank不是第二套记忆库。
mnemosyne:代码、Node、Core,负责运行和认知。Mnemosyne Memory Bank:Node 管理的数据目录(SQLite + runtime),不是代码仓。mnemosyne-memory-bank:Memory Bank 的公开说明仓,不含独立数据库、不启动服务、不保存个人数据。项目隔离用 Bank,跨设备才用多 Node;不要让两套系统同时对同一份长期认知拥有写入权。
它希望解决的不是简单的对话历史保存问题,而是如何让 Agent 在长期运行中持续积累经验:将经历转化为证据,将证据组织成记忆,在新信息出现时更新已有认知,并通过行为结果和反馈不断改善未来的判断。
Mnemosyne 以独立运行、模块化设计、可追溯数据和可组合服务为核心原则。它可以作为独立记忆系统运行,也可以通过适配器接入 DeepSeek Harness(DSH)等 Agent 宿主。
2.0 仓库结构
| 路径 | 作用 |
|---|---|
service/ | 独立 Mnemosyne Node:Core、REST/MCP、Memory Bank、测试与文档 |
src/ + package.json | DSH 插件适配层:启动/守护 Node、注册 memory_* 工具 |
legacy/dsh-plugin/ | 0.2 旧 DSH 插件归档,仅供追溯,不再作为主入口 |
从拆分到统一:合并了什么
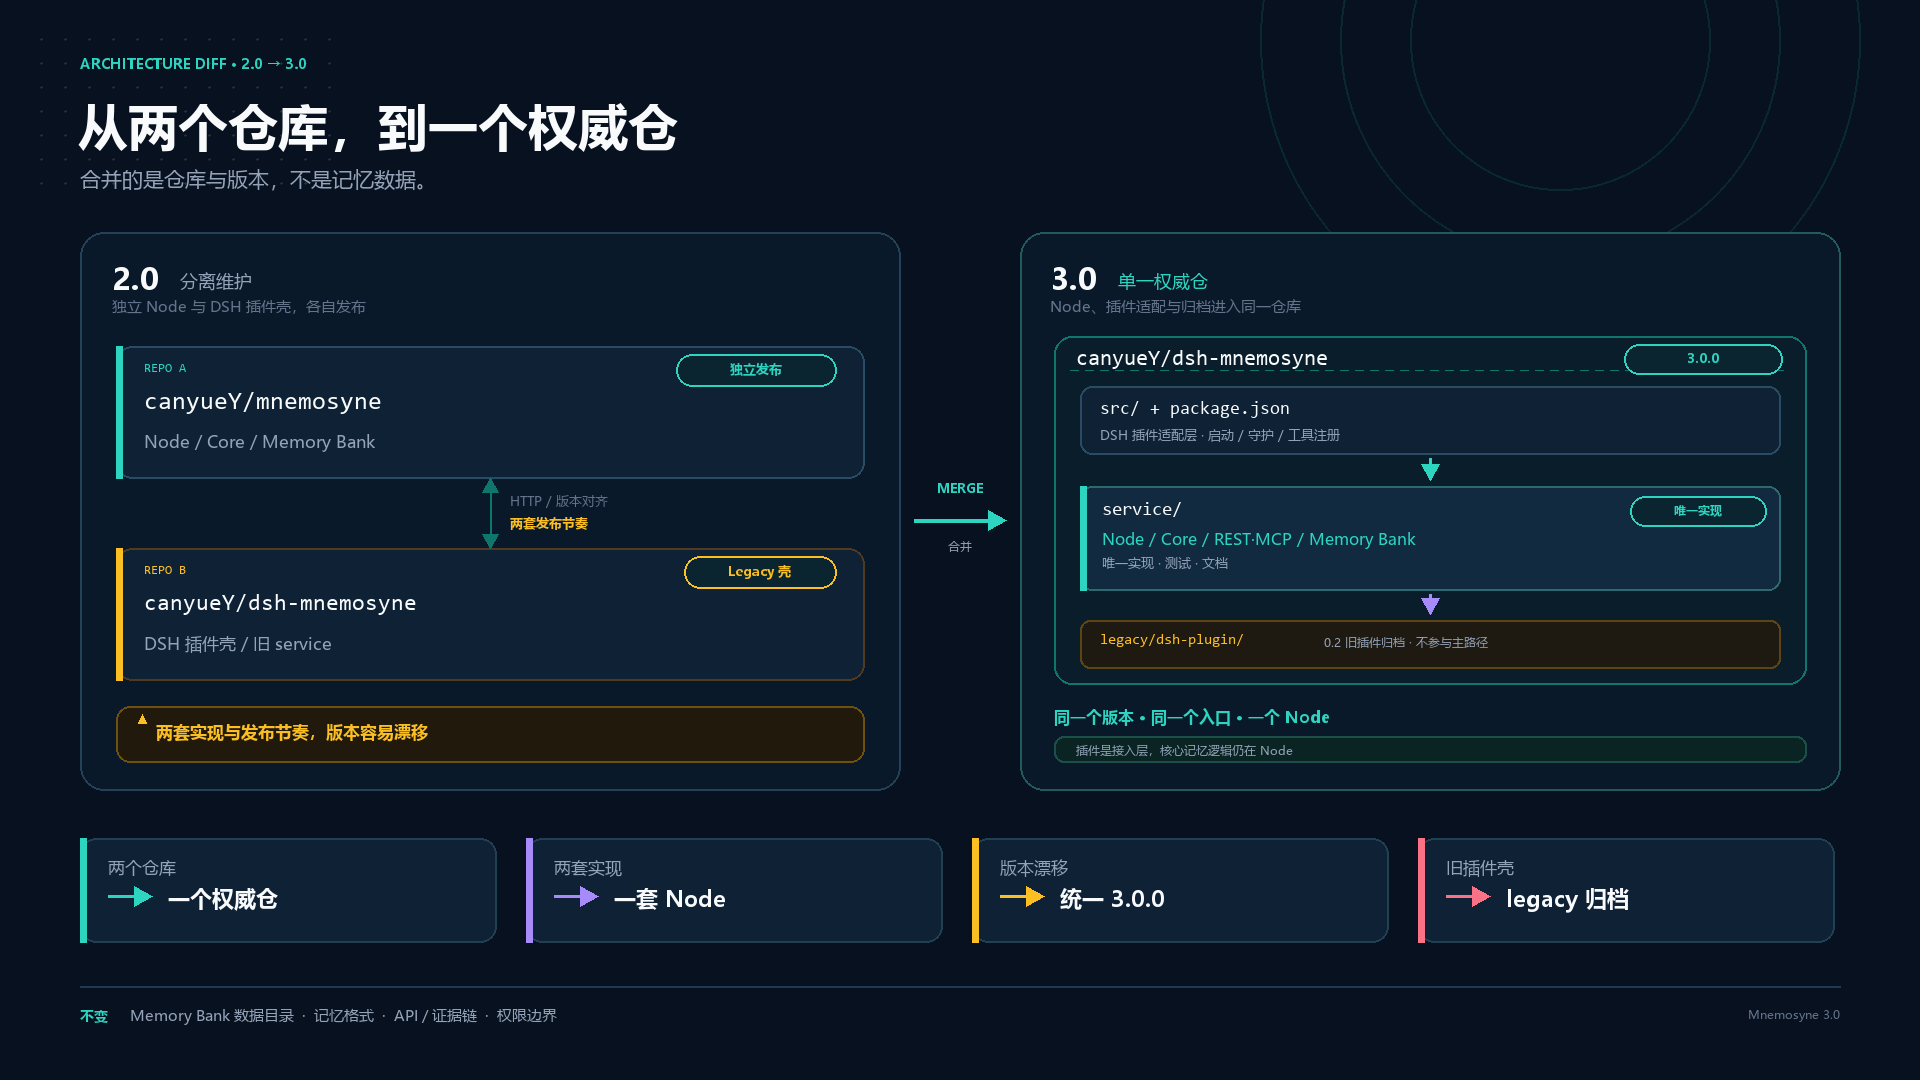
旧版的两个入口,收敛为 2.0 的一个权威仓;Node、DSH 适配层与旧插件归档各归其位。
全部差异与重点
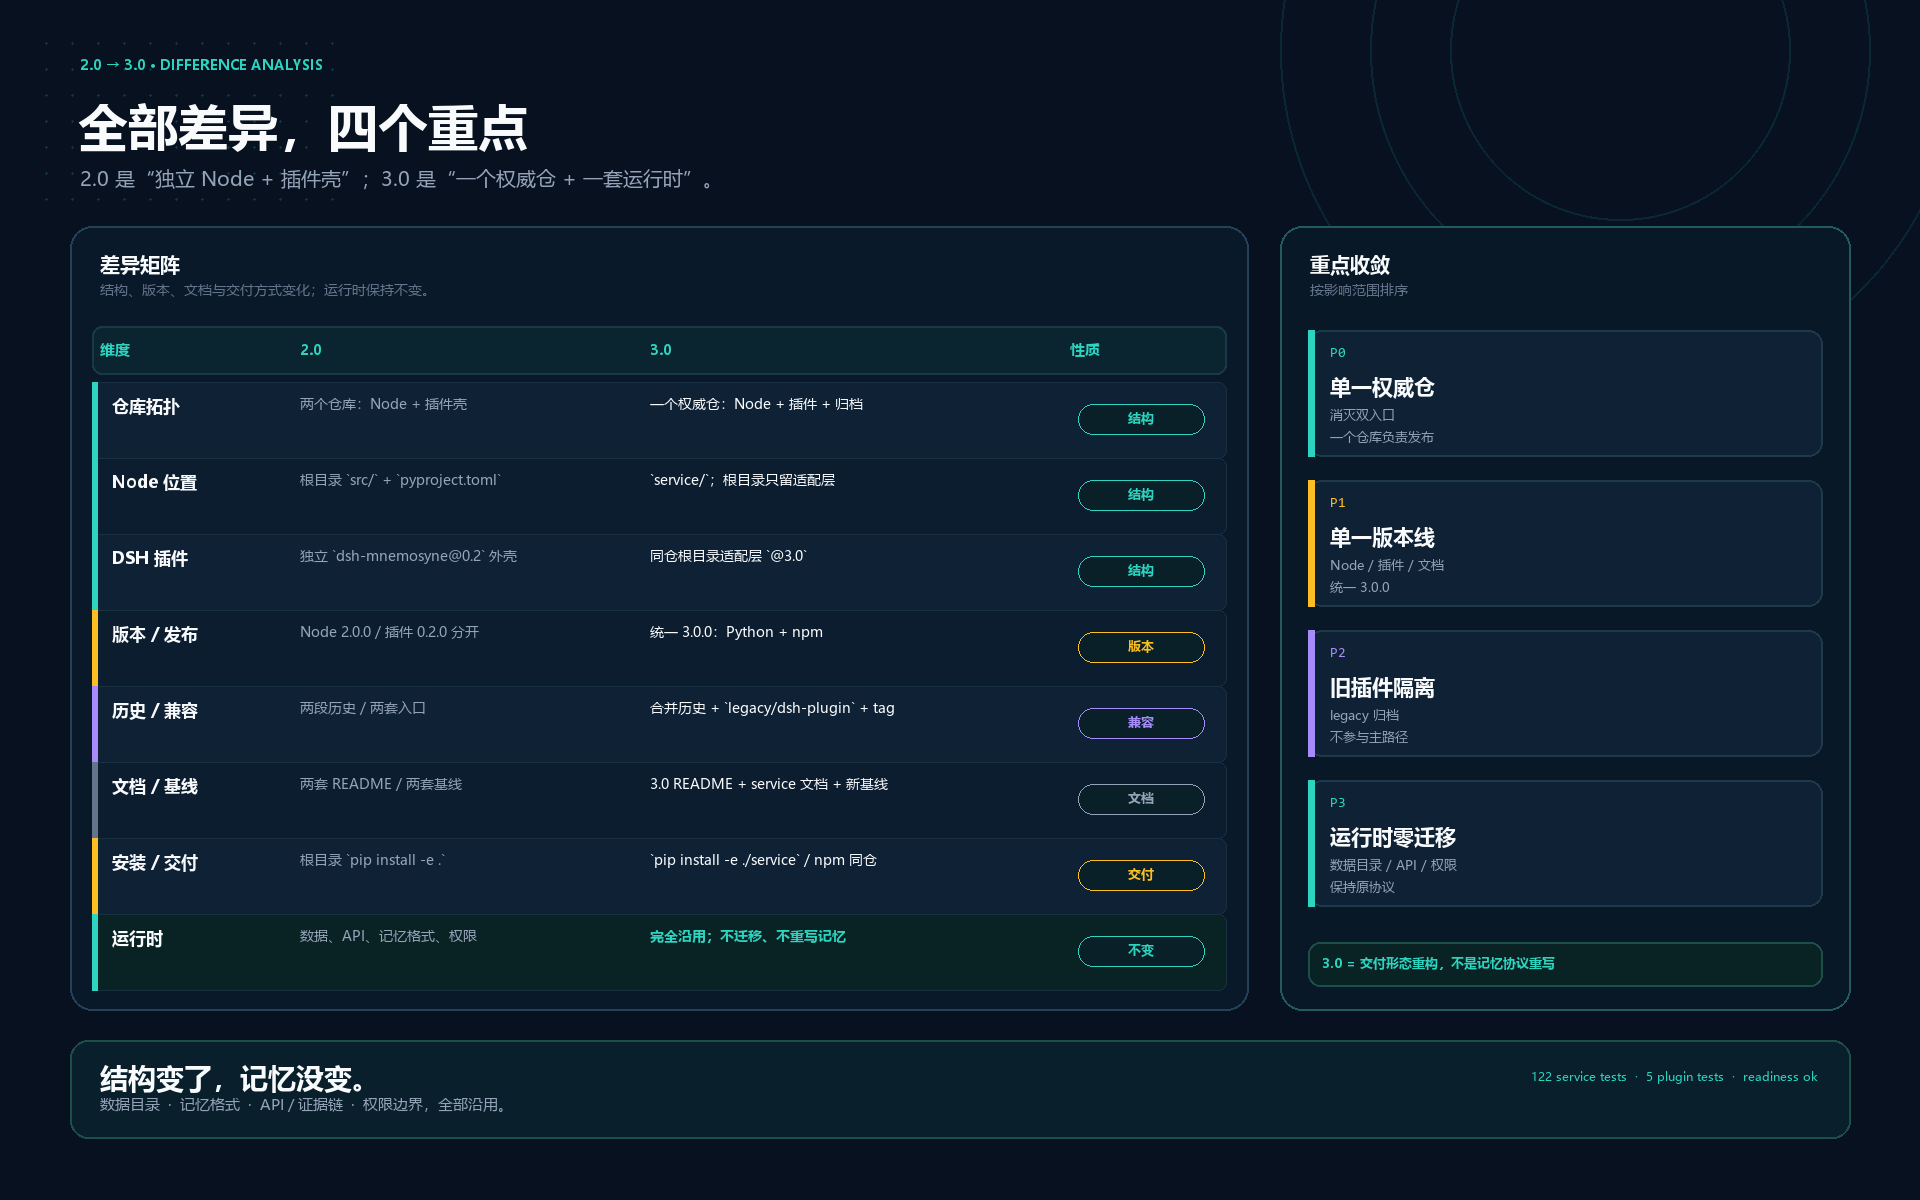
八个维度看差异;真正要守住的是运行时四件事:数据目录、记忆格式、API / 证据链、权限边界。
旧版 / 2.0 统一版 / Roadmap:能力代际
重要口径: 当前 2.0 统一版是仓库合并与版本统一,不是算法跃迁。 结构发现、假设生成、策略学习、认知依赖图与受控自主演化,属于 Roadmap,尚未作为已交付能力。 旧版 2.0 是可信认知基础;2.0 统一版先完成交付收敛;Roadmap 才讨论认知自演化。
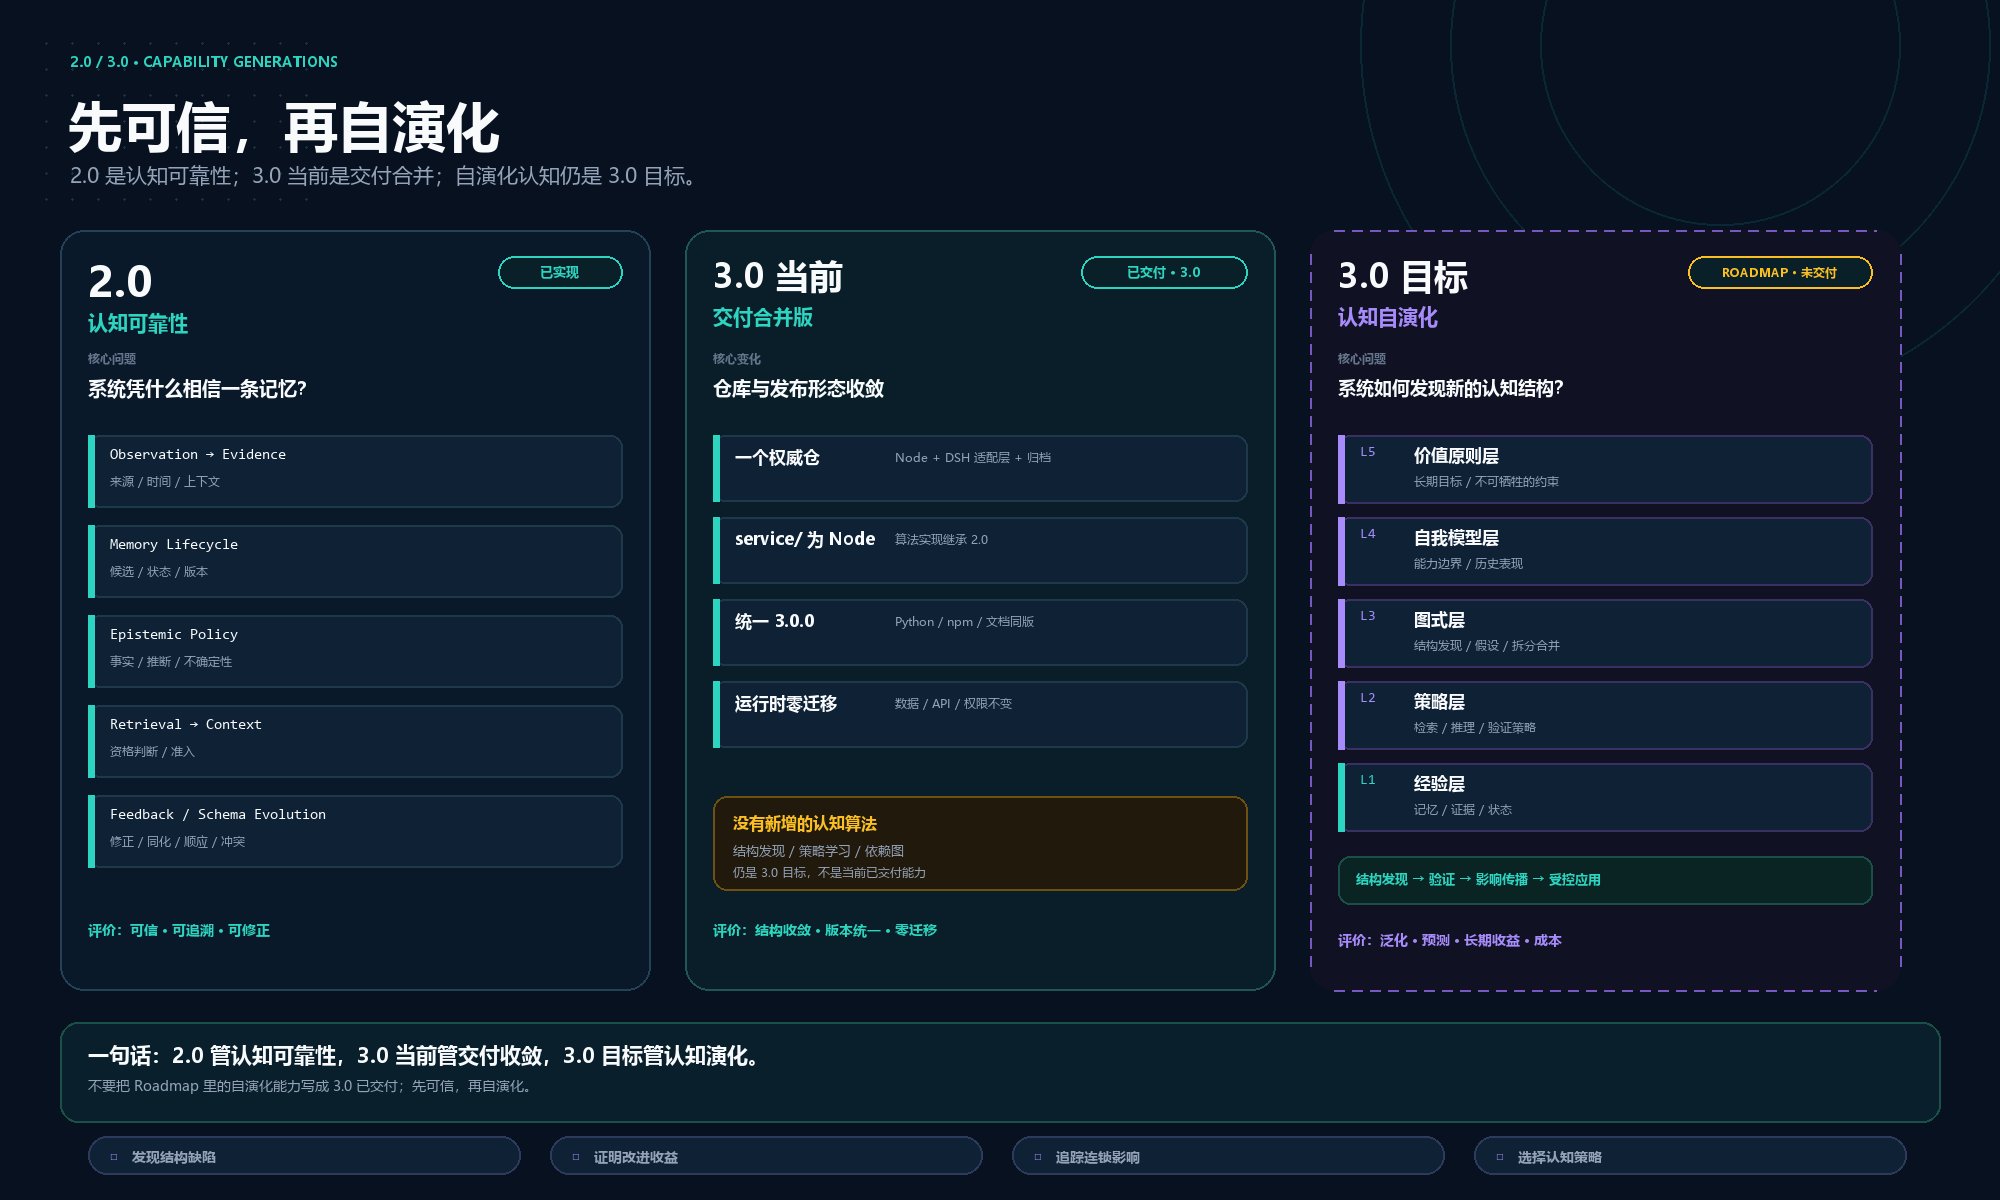
左:旧版 2.0 认知可靠性;中:2.0 统一版交付合并;右:Roadmap 认知自演化。
完整算法分层、现有代码缺口与优先级见 MNEMOSYNE_ROADMAP.md。
| 维度 | 旧版 2.0(已实现) | 2.0 统一版(已交付) | Roadmap |
|---|---|---|---|
| 核心问题 | 系统凭什么相信一条记忆? | 如何把 Node 与插件收敛成一个发布单元? | 系统如何发现新的认知结构? |
| 主要对象 | 观察、证据、记忆、状态、关系 | 同一套 Node、仓库边界、版本与交付 | 假设、知识结构、策略、长期结果 |
| 主要算法任务 | 证据关联、可信度、检索准入、状态更新 | 不新增算法,继承 2.0 | 结构发现、假设生成、冲突解释、策略优化 |
| 记忆检索 | 找到相关信息,并判断是否有资格进入上下文 | 同样;额外保证同仓交付与版本一致 | 进一步判断哪些信息有助当前任务与长期学习 |
| 认知更新 | 根据新证据和反馈修正已有认知 | 同样;结构不变 | 主动发现缺口,提出并检验新的解释 |
| 学习方式 | 从用户反馈、任务结果调整记忆 | 同样;未新增学习策略 | 根据长期结果比较假设和策略的有效性 |
| Schema Evolution | 对既有结构做有依据的调整 | 同样;图式演化能力保留 | 发现更合适的结构,并验证结构调整是否真正改善表现 |
| 自主性 | 在既定规则与权限内更新 | 同样;自主性没有提升 | 在安全边界内选择要探索、验证和优化的对象 |
| 主要评价指标 | 事实可靠性、来源保留、检索准确性、更新可追溯性 | 仓库收敛、版本统一、运行时零迁移 | 泛化能力、预测质量、长期收益、结构质量、调整成本 |
| 当前状态 | 旧版 2.0 已归档,历史保留 | 2.0.0 已交付 | 未交付,按 Capability Gate 分阶段 |
Roadmap 优先级
| 优先级 | 能力 | 说明 |
|---|---|---|
| P0 | 认知结构发现与验证 | 发现既有图式的不足,提出可验证的结构变更,并比较收益 |
| P1 | 认知依赖图与影响传播 | 核心判断变化时,识别哪些推断、策略和下游结果需要重新评估 |
| P2 | 元认知与策略学习 | 评估自身表现,学习在不同情境下选择检索、推理、验证或询问用户 |
| P3 | 受控自主演化 | 在前述能力验证后,分阶段开放更高程度的自动化 |
验收四问
- 能否发现原有知识结构的缺陷?
- 能否证明结构修改是有收益的?
- 能否追踪认知修改的连锁影响?
- 能否学会选择更合适的认知策略?
先可信,再自演化。 如果系统还不能判断一种认知结构是否更好,就不应该让它自主地大规模修改自己的认知结构。
2.0 统一版升级内容
2.0 统一版不是功能堆叠,而是把旧版 2.0 的独立 Node 与 DSH 插件壳收敛为一个发布单元。
| 类别 | 升级内容 |
|---|---|
| 仓库 | canyueY/mnemosyne + canyueY/dsh-mnemosyne → 一个 canyueY/dsh-mnemosyne |
| Node | 从仓库根目录迁入 service/;Node / Core / Memory Bank 实现不变 |
| DSH 插件 | 根目录 src/ + package.json 保留为适配层;启动并守护 service/ |
| 版本 | Node 2.0.0 / 插件 0.2.0 → 统一 2.0.0 |
| 旧插件 | 0.2 完整归档到 legacy/dsh-plugin/,保留 tag legacy/dsh-plugin-0.2.0 |
| 文档 | 2.0 README + service/docs/ + 新的 REPO_BASELINE |
| 数据 | 不迁移:继续使用 %LOCALAPPDATA%\Mnemosyne Memory Bank |
| 兼容 | REST 前缀 /api/v1、记忆格式、权限与证据链保持原协议 |
从旧版 2.0 升级
建议新目录 clone,不要把旧 2.0 工作区直接覆盖:
git clone https://github.com/canyueY/dsh-mnemosyne.git
cd dsh-mnemosyne
python -m venv .venv
Windows:
.venv\Scripts\activate
Linux / macOS:
source .venv/bin/activate
安装 2.0 Node:
pip install -e "./service[dev]"
mnemosyne doctor
mnemosyne start
DSH 插件升级:
dsh plugin --profile web add github:canyueY/dsh-mnemosyne#main
升级后确认:
数据目录仍为 %LOCALAPPDATA%\Mnemosyne Memory Bank
REST 仍为 /api/v1
旧 DSH\cognitive-memory 只作为归档,不再作为默认路径
不需要迁移记忆数据。 统一版变的是代码位置、仓库边界和发布版本;Memory Bank 的数据目录、记忆格式和 API 语义保持兼容。
回退
- 需要查看 2.0 源码:
git checkout v2.0.0(历史 tag,目录为旧根结构); - 需要旧 DSH 插件:使用 tag
legacy/dsh-plugin-0.2.0或归档目录; - 旧
canyueY/mnemosyne仓库已归档,不再接收新修复。
2.0 统一版是合并后的全新版本:不再把 DSH 插件壳与 Node 分成两个仓库维护。旧 npm 包
dsh-mnemosyne@0.2仍可在 npm 历史中安装,但不再接收新能力。
迁移细节与版本兼容见 MIGRATION_2.0.md。
目录
- 1. 核心思想
- 2. 项目定位
- 3. 核心特点
- 4. 整体架构
- 5. 核心实现方案
- 6. 模块化设计
- 7. 安装与运行
- 8. DSH 集成
- 9. 开发与测试
- 10. 设计边界
- 11. 未来方向
- 12. 项目理念
1. 核心思想
传统 Agent Memory 通常关注两个问题:
- 保存了什么?
- 需要时能否检索出来?
Mnemosyne 希望进一步解决三个问题:
- 新经验如何改变已有记忆?
- 已有判断如何在反证出现时得到修正?
- 一次经验如何改善 Agent 下一次的判断与行动?
因此,Mnemosyne 将记忆视为一个持续演化的过程:
Experience → Evidence → Memory → Retrieval → Action → Feedback → Evolution
                新经历  新信息
                       │
                       ▼
                 Observation
                       │
                       ▼
                   Evidence
                       │
                       ▼
             Candidate  Evaluation
                       │
                       ▼
                 Memory Bank
                       │
                       ▼
             Retrieval  Context
                       │
                       ▼
                 Agent Action
                       │
                       ▼
                Feedback  Outcome
                       │
                       ▼
              Schema  Memory Evolution
                       │
                       └───────► 新一轮经验
记忆不是静态仓库,而是一个能够随着证据变化而持续调整的系统。
核心原则
- 证据优先: 记忆必须尽可能保留来源、时间和可信程度。
- 事实与推断分离: Agent 的推测不能自动成为用户事实。
- 变化优先于覆盖: 新信息不应无条件覆盖旧信息。
- 可追溯: 记忆的形成、更新和失效应当能够追踪。
- 模块独立: 每项能力具有清晰边界,避免整个系统绑定单一宿主。
- 渐进演化: 新能力应当可以独立测试、替换和逐步接入。
- 经验复利: 每一次有效经验都应有机会改善未来的判断。
2. 项目定位
| 属性 | 说明 |
|---|---|
| 项目名称 | Mnemosyne |
| 项目定位 | Evolving Memory Infrastructure |
| 项目类型 | AI Agent 记忆基础设施 |
| 核心目标 | 长期记忆、证据管理、认知演化与反馈学习 |
| 核心实现 | Node Host + Python FastAPI Service |
| 接入方向 | DSH、独立 Agent、外部应用 |
| 设计原则 | Modular、Independent、Traceable、Composable |
Mnemosyne 不试图成为一个完整的 Agent 框架。
它不负责替代模型推理、工具执行、任务编排或 Agent 人格,而是为这些系统提供可复用的记忆能力。
Agent 决定如何行动,Mnemosyne 负责让行动能够建立在可靠的历史经验之上。
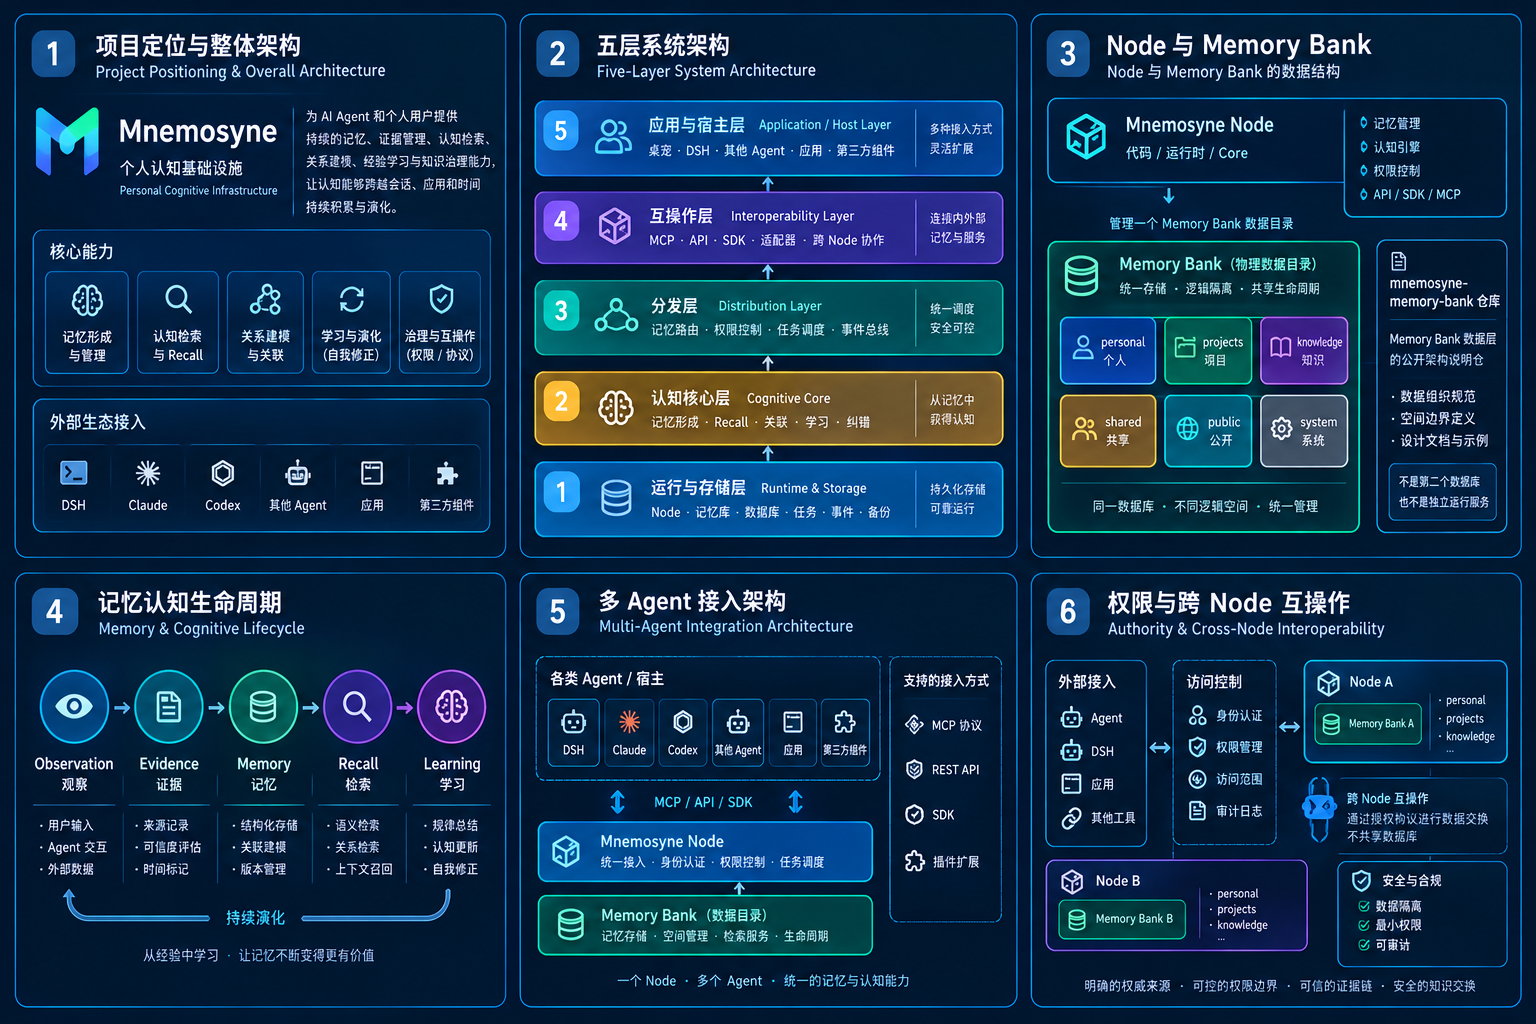
项目定位、五层系统架构、Node 与 Memory Bank、记忆认知生命周期、多 Agent 接入与跨 Node 互操作总览。
2.1 官方定义:个人认知基础设施
Mnemosyne 是个人认知基础设施(Personal Cognitive Infrastructure)。
它为 AI Agent 和其他智能应用提供一套独立、持久、可治理、可演化的认知能力,让它们能够积累经验、形成记忆、理解关系、检索过去、修正认知,并在时间中持续学习。
Mnemosyne is an open, independent Personal Cognitive Infrastructure for AI Agents.
一句话定位:
让记忆成为认知的基础,让认知能够持续演化。
记忆是 Mnemosyne 的基础能力,认知才是它要承载的整体能力。
2.2 它不是什么
| 定义 | 是否属于 | 原因 |
|---|---|---|
| 算法插件 | 不完全是 | 算法只是内部实现,可以替换和扩展 |
| 记忆库(Memory Store) | 是,但不完整 | 需要持久化、组织和管理记忆 |
| 向量数据库 | 不是 | 向量检索只是检索手段之一 |
| RAG 系统 | 不只是 | RAG 主要解决知识检索与上下文注入 |
| Agent 插件 | 不完全是 | 插件只是接入某个宿主的方式 |
| 记忆中间件 | 部分是 | 提供统一接口,但不应只是数据转发层 |
| 认知引擎(Cognitive Engine) | 是核心组成 | 负责记忆形成、检索、关联、推理和演化 |
| 个人认知基础设施 | 最准确的整体定义 | 同时涵盖数据、认知能力、治理、运行和生态接入 |
Mnemosyne 由四部分组成,而不是四个独立产品:
- 记忆系统:保存什么,以及如何组织信息。
- 认知引擎:如何从信息中形成、检索和修正认知。
- 运行与存储:如何让系统独立运行、可靠持久化。
- 治理与互操作:谁能访问、访问什么,以及如何与外部系统协作。
2.3 与外部记忆系统的关系
会有重叠,但不必然冲突。真正的风险不是 Mnemosyne 和其他记忆库同时存在,而是它们同时对同一份记忆拥有写入权、修改权和最终解释权。
Mnemosyne 不排斥其他记忆系统,而是成为个人认知的权威层(Cognitive Authority Layer),通过适配器与其他记忆库协作。
| 关系 | 是否冲突 | 说明 |
|---|---|---|
| Mnemosyne 与 Agent 自带记忆并存 | 不冲突 | Agent 可以保留自己的会话记忆和运行状态 |
| Mnemosyne 与其他记忆库互相读取 | 不冲突 | 通过授权和适配器交换信息 |
| Mnemosyne 与其他记忆库同时管理同一份长期个人认知 | 有冲突风险 | 可能产生重复记忆、版本不一致、事实矛盾和权限混乱 |
不同系统保存的内容并不相同:
| 系统 | 主要职责 | 建议关系 |
|---|---|---|
| Agent 会话记忆 | 当前对话、短期上下文 | 保留在 Agent |
| Agent 工作记忆 | 当前任务状态、中间结果 | 保留在 Runtime |
| 项目知识库 | 项目文档、代码、技术规范 | 保留在原知识源 |
| 向量数据库 | Embedding 和相似度索引 | 可作为 Mnemosyne 的检索 Provider |
| Graphiti 等时序图记忆系统 | 实体关系和时间变化 | 可作为算法或存储能力接入 |
| Mem0、LangMem 等记忆方案 | 记忆提取、更新和检索 | 可作为适配对象或算法参考 |
| Mnemosyne | 个人长期认知、证据、关系、经验与治理 | 个人认知权威层 |
不是所有 Agent 能访问的数据,都应该被复制成 Mnemosyne 的长期记忆。
例如,项目文档本身可以继续保存在 GitHub;Mnemosyne 只记录用户参与该项目的经历、重要决策、个人偏好,以及指向原始文档的引用。Agent 需要项目最新状态时,仍然应该回到原始文档查询。
2.4 权威模型:冲突由谁解释
Mnemosyne 需要明确的 Authority Model,不能因为自己是中心系统就直接覆盖外部数据。
| 信息 | 来源 | 状态 |
|---|---|---|
| 使用 Python | 2025 年的用户表达 | 历史事实 |
| 使用 TypeScript | 2026 年的用户表达 | 当前有效事实 |
| 主要使用 Python | 另一个 Agent 的记忆 | 可能过期,待核验 |
Mnemosyne 应当负责:
- 保存原始来源和时间。
- 判断新旧信息之间是否存在冲突。
- 建立历史版本和当前有效状态。
- 记录证据和修正过程。
- 根据授权向其他系统发布更新。
Mnemosyne 的权威性来自证据、用户授权和明确的治理规则,而不是来自它拥有更大的数据库。
2.5 四种接入模式
| 模式 | 说明 | 适用场景 |
|---|---|---|
| A. 独立记忆(推荐默认) | 其他记忆库独立运行,Mnemosyne 不接管 | 会话记忆、任务状态、项目缓存 |
| B. 只读接入 | Mnemosyne 可以检索外部记忆,但不修改其内容 | 已有 Agent Memory、企业知识库 |
| C. 双向同步 | 双方按字段、范围、版本和授权规则同步 | 用户明确授权的长期记忆迁移或协作 |
| D. Mnemosyne 托管认知 | 外部 Agent 把长期个人认知交给 Mnemosyne,自身只保留工作状态和缓存 | 以 Mnemosyne 为主要记忆基础设施的 Agent |
这四种模式不能混为一谈。尤其是双向同步 ≠ 双方可以无条件覆盖对方的数据。
2.6 Memory Interoperability Layer
建议在 Mnemosyne 中增加一个明确的逻辑层:
Memory Interoperability Layer(记忆互操作层)
它不负责记忆本身的认知判断,而负责与外部记忆系统建立可控连接。
| 模块 | 职责 |
|---|---|
| Memory Provider Registry | 登记外部记忆系统 |
| Memory Adapter | 转换外部数据结构 |
| Identity Mapping | 映射用户、Agent、Node 身份 |
| Scope Mapping | 映射 Memory Bank 和外部命名空间 |
| Authority Resolver | 判断数据的权威来源 |
| Conflict Resolver | 检测和处理记忆冲突 |
| Sync Coordinator | 增量同步、版本管理和重试 |
| Provenance Tracker | 保存来源、证据和变更历史 |
| Permission Gateway | 控制读取、写入、同步和撤销 |
Agent A Memory
Agent B Memory
External Knowledge
Other Memory Store
        │
        ▼
Memory Interoperability Layer
Adapter · Identity · Permission · Provenance · Conflict · Sync
        │
        ▼
Mnemosyne Cognitive Core
Evidence · Memory · Relationship · Recall · Learning · Governance
外部系统通过受控接口协作,不直接访问核心数据库。
2.7 必须坚持的五条原则
- 不强制替换:外部记忆库可以继续存在。
- 不默认复制:外部信息先作为外部数据或 Observation,不自动成为个人事实。
- 不允许双重权威:同一认知对象必须明确权威来源和写入规则。
- 不丢失来源:同步后的记忆仍然能够追溯到原始系统和证据。
- 不默认共享:一个 Agent 的私人记忆不能因为接入 Mnemosyne 就自动对其他 Agent 可见。
2.8 最终定位
Mnemosyne 是个人认知基础设施,也是个人长期认知的权威管理层。 它不要求取代所有外部记忆系统,而是通过开放协议连接、整合和治理它们,使个人认知能够跨 Agent、跨应用、跨时间持续积累与演化。
Mnemosyne 不是要成为世界上唯一的记忆库,而是要成为用户自己的认知中心。
其他系统可以有自己的记忆,但用户的长期个人认知由谁负责、依据什么更新、如何纠错、谁可以访问,应当有清晰且可迁移的规则。
记忆互操作层与权威模型纳入 Mnemosyne 2.0 架构设计;跨 Node 的联邦同步继续放在后续阶段,不因此扩大 2.0 GA 范围。
2.9 层级关系
| 名称 | 定义 | 与 Mnemosyne 的关系 |
|---|---|---|
| Mnemosyne | 个人认知基础设施 | 整体系统 |
| Mnemosyne Node | 独立运行的认知节点 | 部署和运行实体 |
| Mnemosyne Core | 认知与记忆核心能力 | 核心引擎 |
| Memory Bank | 具有独立边界的记忆空间 | 记忆组织与隔离机制 |
| Cognitive Algorithm | 检索、归纳、关联、学习等算法 | 可替换的内部实现 |
| Adapter / Plugin | 外部系统接入适配器 | 扩展和集成方式 |
| SDK / API / MCP | 外部调用接口 | 互操作入口 |
Mnemosyne ≠ Mnemosyne Node ≠ Memory Bank。 Mnemosyne 是整套基础设施;Node 是一次独立运行实例;Memory Bank 是 Node 内部的逻辑记忆空间。
2.10 运行时边界:一个 Node,一个 Memory Bank
| 层 | 实体 | 是否独立存储 | 说明 |
|---|---|---|---|
| 代码 | canyueY/dsh-mnemosyne | 否 | Node / Core / API / SDK |
| 运行 | Mnemosyne Node | 是,一个 Node 一个数据根 | 进程、配置、事务、任务 |
| 数据 | Mnemosyne Memory Bank | 是,Node 的物理数据目录 | SQLite、runtime、logs、components |
| 逻辑 | Personal / Projects / Knowledge / Shared / Public / System | 否,同一数据库内的 Bank | 权限、检索范围、隔离 |
| 文档 | canyueY/mnemosyne-memory-bank | 否 | 架构与数据契约说明,不是运行时 |
同一 Node 内:
- 不同项目用不同 Bank,不复制数据库;
- 默认检索只查
personal; shared/public不会被自动带进personal;- 需要显式指定
banks才能跨空间检索。
不同 Node 之间:
- 不共享同一个 SQLite;
- 通过 API / SDK / MCP / 导入导出交换;
- 同一认知必须有明确权威来源,不能双写;
- 跨 Node 联邦按规划放在 2.1+。
推荐形态:
一个用户
  └─ 一个 Mnemosyne Node
       └─ 一个 Memory Bank
            ├─ personal
            ├─ projects
            └─ knowledge
mnemosyne有记忆库,mnemosyne-memory-bank没有独立记忆库。 两者逻辑上重合、可以关联,但不应该各自维护一套数据库。
3. 核心特点
3.1 基础设施优先
Mnemosyne 不将自身限制为某个 Agent 框架的附属插件。
它以独立服务为核心,将记忆处理、存储、检索和演化能力封装为可复用的基础设施。
这意味着:
- 不要求 Agent 与记忆系统使用同一种语言。
- 不要求所有调用者都运行在同一个进程中。
- 不要求记忆能力只能通过某个插件入口访问。
- 不要求未来新增的 Agent 框架重新实现一套记忆系统。
DSH 是重要的集成宿主,但不是 Mnemosyne 唯一的使用方式。
3.2 模块化与独立运行
每项能力尽量拥有明确的输入、输出和职责。
例如:
- Schema Evolution 可以独立处理图式演化。
- Feedback Learning 可以独立评估反馈信号。
- Semantic Retrieval 可以独立提供语义相关性信号。
- Memory Bank 负责记忆数据的组织和管理。
模块之间通过明确的数据契约协作,而不是依赖彼此的内部实现。
3.3 记忆具有生命周期
一条信息不应该只有内容,还应该有来源、状态和变化过程。
Mnemosyne 将记忆相关过程组织为:
Observation → Evidence → Candidate → Memory → Review → Evolution
让系统能够区分:
- 新出现的信息。
- 已经验证的事实。
- 尚待确认的候选判断。
- 与旧记忆存在冲突的信息。
- 已经失效或被新状态取代的信息。
3.4 认知演化
基于图式理论,Mnemosyne 将新经验与既有认知之间的关系分为:
| 类型 | 含义 |
|---|---|
| Assimilation | 同化:新经验可以纳入既有图式 |
| Accommodation | 顺应:调整既有图式的内容或适用范围 |
| Conflict | 冲突:反证足以使图式进入争议状态 |
当前实现由 cognition/schema_evolution.py 提供。
其中,默认 confirm=False,先预览演化结果,确认后才写入版本,避免新证据静默覆盖已有认知。
3.5 反馈驱动的学习
Mnemosyne 不把所有反馈混为一谈。
当前将反馈区分为:
| 信号 | 含义 | 权重 |
|---|---|---|
user_explicit | 用户明确表达的评价或纠正 | 0.10 |
outcome | 实际行为结果 | 0.06 |
self_eval | Agent 自我评估 | 0.02 |
三种信号具有不同的证据意义。
尤其是 Agent 自评不能直接改变用户事实;负向信号可以要求后续 Review 或 Change Plan 介入。
对应实现:cognition/feedback_learning.py。
3.6 可选语义能力
语义检索是可插拔能力,不是记忆系统唯一的判断依据。
当前实现:
- 默认使用轻量级
hashed_embedding()。 - 允许注入真正的
EmbeddingProvider。 - 通过
SemanticScorer.blend()融合词法与语义信号。 - 语义加分权重上限为 0.6。
- 不替代原有 FTS、Planner 和证据、时间、情境评分。
对应实现:retrieval/semantic.py。
默认哈希表示是轻量级相似性特征,并不等价于完整的自然语言语义理解。
4. 整体架构
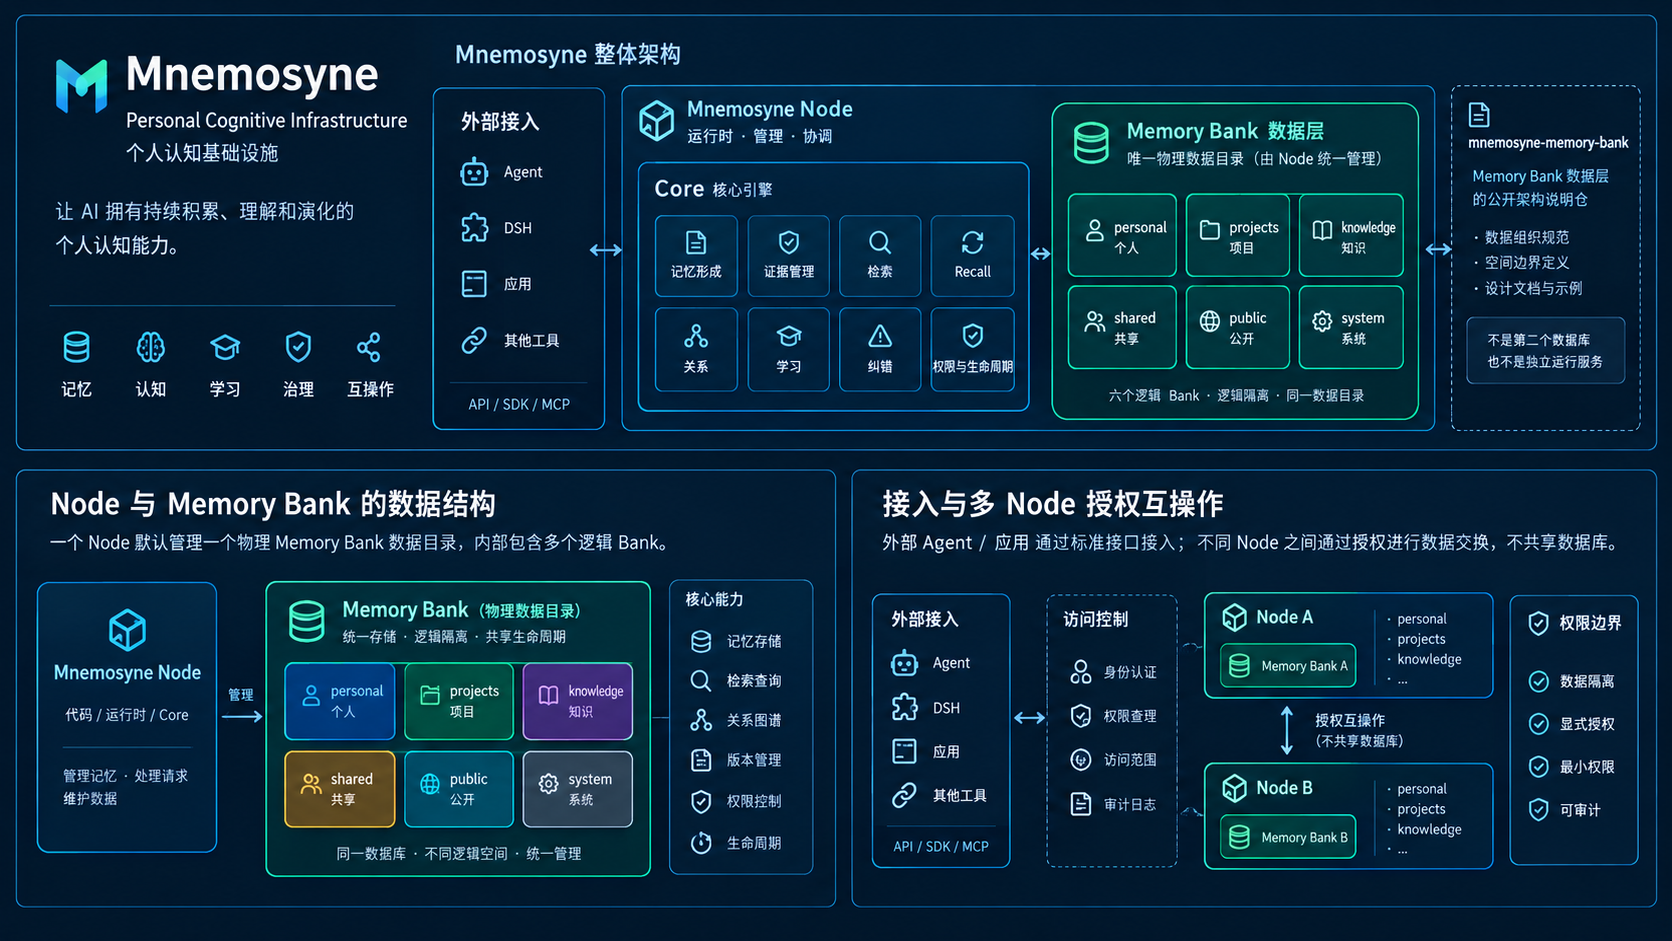
外部接入 → Mnemosyne Node / Core → Memory Bank 数据层;不同 Node 之间通过授权互操作,不共享数据库。
Mnemosyne 采用 Host 与 Service 分离的架构思路。
                 Agent  Application
                         │
                         ▼
                  Integration Layer
                   DSH  REST  MCP
                         │
                         ▼
                    Node Host
                         │
                Service Integration
                         │
                         ▼
                 Python Memory Service
                         │
          ┌──────────────┼──────────────┐
          ▼              ▼              ▼
       Cognition      Retrieval       Memory
          │              │              │
          ▼              ▼              ▼
    Schema Evolution  Semantic       Memory Bank
    Feedback Learning  Scoring       Evidence
    Change Planning    Ranking        History
                         │
                         ▼
                 Persistent Storage
Node Host
负责宿主集成和服务调用。
主要目标:
- 提供统一的应用接入入口。
- 管理宿主侧生命周期。
- 连接独立记忆服务。
- 将底层能力适配为 Agent 可使用的接口。
Python Memory Service
负责记忆核心处理能力。
主要目标:
- 记忆数据处理。
- 证据与状态管理。
- 认知演化。
- 反馈学习。
- 检索与评分。
- 与存储层协作。
Memory Bank
负责长期记忆的组织与持久化。
它不应该依赖某一个 Agent 的运行状态,也不应该将所有数据直接绑定到单次对话上下文。
5. 核心实现方案
5.1 Observation → Evidence → Candidate
系统首先接收观察信息,再将其组织为可评估的证据。
这一步重点是保留来源和上下文,而不是急于生成结论。
5.2 Memory Evolution
当新信息进入系统时,与现有记忆进行匹配。
根据证据关系决定:
- 补充旧记忆。
- 调整旧记忆的适用范围。
- 创建新版本。
- 标记冲突。
- 提交人工或后续流程审查。
5.3 Feedback Learning
行为结果和用户反馈分别进入学习过程。
系统需要区分:
- 用户明确认可。
- 用户明确纠正。
- 实际行动成功。
- 实际行动失败。
- Agent 自我判断。
这样可以避免把一次成功执行错误地解释为用户认同。
5.4 Semantic Retrieval
语义信号参与检索排序,但不能压过证据可靠性、时间有效性和情境匹配。
未来可以根据实际需求注入不同的 Embedding Provider,而无需重写整个检索系统。
5.5 Experience Loop
最终形成:
Experience
    ↓
Evidence
    ↓
Memory
    ↓
Recall
    ↓
Action
    ↓
Feedback
    ↓
Evolution
    └───────────────↺
这条闭环是 Mnemosyne 的长期核心。
6. 模块化设计
Mnemosyne 希望将能力设计成可独立维护的模块。
| 模块 | 职责 |
|---|---|
| Observation | 接收原始观察 |
| Evidence | 管理证据及其来源 |
| Memory | 记忆生命周期管理 |
| Schema Evolution | 图式同化、顺应与冲突处理 |
| Feedback Learning | 用户反馈、结果和自评信号 |
| Retrieval | 记忆召回与排序 |
| Semantic | 语义相关性信号 |
| Memory Bank | 记忆存储与命名空间组织 |
| Integration | DSH 和其他宿主的适配 |
模块化的目标不是拆出尽可能多的文件,而是让模块具备独立演进的能力。
未来可以替换某个模块,而不必重写整个系统。
7. 安装与运行
环境要求
- Node.js 20+
- Python 运行环境
- Git
- 对应 Python 服务所需的依赖
获取项目
git clone https://github.com/canyueY/dsh-mnemosyne.git
cd dsh-mnemosyne
安装 Node 侧依赖
npm install
Python 服务环境
建议使用独立虚拟环境:
python -m venv .venv
Windows:
.venv\Scripts\activate
Linux / macOS:
source .venv/bin/activate
cd service
pip install -e ".[dev]"
启动方式
Mnemosyne 的运行由 Node Host 与 Python Service 两部分组成。
实际启动脚本、服务地址、环境变量和配置文件应以当前版本仓库中的配置为准。
不要将开发环境中的默认路径和端口直接当作生产环境配置。
注意:以上为环境准备流程。完整的一键启动命令应在仓库统一启动脚本和服务配置稳定后补入。
8. DSH 集成
Mnemosyne 提供独立的 DSH 插件接入层。
插件仓库:
https://github.com/canyueY/dsh-mnemosyne
安装:
# 远程
dsh plugin --profile web add github:canyueY/dsh-mnemosyne#main

# 本地仓库自安装
dsh plugin --profile web add "file:<dsh-mnemosyne 绝对路径>"
完整安装步骤、DSH 接口适配清单、卸载/回滚与故障排查见 DSH_INTEGRATION.md。
目前可通过插件入口使用记忆能力,例如:
memory_searchmemory_contextmemory_observememory_feedback
插件负责将 DSH 的调用适配到 Mnemosyne 的记忆能力,不应成为记忆核心逻辑唯一的实现位置。
核心实现与宿主插件保持分离,有利于未来接入其他 Agent 框架。
9. 开发与测试
Mnemosyne 的开发强调模块级测试与完整回归。
当前经验闭环新增测试:
service/tests/unit/test_experience_loop.py
覆盖:
- 图式演化。
- 反馈学习。
- 语义信号。
- 相关边界行为。
经验闭环提交:
6ce80db
feat: add experience loop
当时独立仓全量测试结果:
119 passed
测试数量和结果会随项目持续变化,请以当前 CI 和最新提交为准。
开发原则:
- 新模块必须具有清晰的输入和输出。
- 重要状态变化必须有测试。
- 不允许自评直接改变用户事实。
- 默认采用保守写入策略。
- 新能力不能破坏既有记忆契约。
- 接口变更需要考虑向后兼容。
10. 设计边界
Mnemosyne 当前不试图实现所有心理学理论。
暂不进入主干的方向包括:
- 社会学习四过程的完整模型。
- 道德发展三水平六阶段。
- 完整的心理空间建模。
- 复杂的自主意识模拟。
这些理论可以成为未来的研究参考,但不应为了理论完整而牺牲工程可维护性。
同时,Mnemosyne 本身不代表 Agent 拥有意识或真实情感。
它提供的是可追溯的经验组织、认知更新和反馈机制。
11. 未来方向
P0 — Core Infrastructure Stabilization
- 统一核心数据契约。
- 完善服务生命周期。
- 增强事务、幂等与错误恢复。
- 完善模块独立测试。
- 明确服务版本和接口兼容策略。
P1 — Experience Loop Integration
- 将图式演化接入真实记忆生命周期。
- 将反馈学习与 Recall、Review、Change Plan 联动。
- 验证经验是否实际改善后续检索和行为。
- 建立端到端经验闭环测试。
P2 — Universal API SDK
- 统一 REST API。
- SDK。
- MCP Adapter。
- 其他 Agent 框架适配器。
这些属于后续接口建设,不应与当前已完成的服务层能力混淆。
P3 — Advanced Retrieval
- 更成熟的 Embedding Provider。
- 混合检索优化。
- 多信号校准。
- 语义关联与跨项目检索。
P4 — Memory Federation
- 多实例协作。
- 跨节点同步。
- 记忆授权与共享。
- 可验证的迁移与恢复。
12. 项目理念
Mnemosyne 希望探索一种新的 Agent 记忆基础设施:
不是让 Agent 永远保存更多内容,而是让它能够在合适的时间找到正确的证据,理解经验的变化,并在新证据出现时修正过去的判断。
记忆的价值不在于存储了多少,而在于它能否让未来变得更好。
项目:
为什么还要开发 Mnemosyne? 阅读全文 →
License
Current Mnemosyne code (src/, service/, scripts/, dsh/) is licensed
under Apache-2.0. The historical legacy/dsh-plugin/ tree remains
AGPL-3.0-or-later; see legacy/dsh-plugin/LICENSE.
Earlier releases remain under the license they were published with.
Third-party dependency notices are in THIRD_PARTY_NOTICES.md.
Versions
| Latest version | Published | Size |
|---|---|---|
| 2.0.0 | — | — |
| 0.2.0 | — | — |
| 0.2.1 | — | — |
| 0.3.0 | — | — |
| 0.3.1 | — | — |
| 0.4.0 | — | — |
| 0.4.3 | — | — |
| 0.4.4 | — | — |
| 0.5.0 | — | — |
| 0.6.0 | — | — |
| 0.7.0 | — | — |
Comments
Loading…