
dsh-audiobook
Manifest validTurn any book into an audiobook inside DeepSeek Harness (dsh) · Search Books Listen: Import a book, and it reads it aloud to you inside DSH
搜书听 · dsh-audiobook
Turn any book into an audiobook inside DeepSeek Harness (dsh). Search public-domain libraries (Project Gutenberg, Wikisource, Internet Archive, Standard Ebooks) by title, author, a character's name or a half-remembered plot, or import your own EPUB, PDF, TXT, DOCX or Markdown file, and listen in the sidebar — Microsoft Edge neural voices, offline Kokoro, or your device's own voices; adjustable speed; it remembers where you stopped.
搜一本书,或者导入一本书,读给你听。 书名、作者、角色名、大概的情节都能搜;声音、语速可选,自动记住听到哪。DSH 插件,也能脱离 DSH 单独用。
dsh plugin --profile desktop add dsh-audiobook
它做什么
-
搜书:面板顶上的搜索框,输入书名、作者,或者只记得的角色名、大概情节(「主角叫贾宝玉的那本」)。在 DSH 里会先让你在 DSH 选的模型猜是哪几本书,再去书源里找;找到点「加入书架」,下载完直接出现在书单里。
书源 有什么 古腾堡计划 7 万多本公版书,英文为主,也有《紅樓夢》《西遊記》等中文古籍(多为繁体) 中文维基文库 中文公版古籍、民国作品(鲁迅等),整部作品导出成 EPUB(大书要一两分钟) 英文维基文库 英文公版作品 Internet Archive 只收标明公有领域或 CC 授权、而且有文字版的书;有不少中文旧书。扫描版的文字是识别出来的,可能有错字,结果里会标出来 Standard Ebooks 精校排版的英文公版书 只接这些公版和授权免费的书源。受版权保护的现代书(比如《围城》)搜不到,AI 猜到了也会照实说「书源里没有」:请买正版电子书后导入。
常规网页搜索:同时用 DSH 自己的网页搜索(就是「插件 → 网页搜索」里配的那个)搜一遍,结果是链接,点「打开」在浏览器里看;网页上下载到的书,用「导入」加进书架。
去别处搜 / 自定义搜索地址:搜索框下面一排链接(默认百度、必应、Google、豆瓣读书、微信读书),点一下在浏览器里打开那个网站的搜索结果。「管理搜索地址」里可以增删改,地址里用
{q}代表要搜的词。地址类型选「OPDS 书库」时(Calibre 内容服务器、calibre-web、Kavita 等自建书库,比如http://地址:8080/opds/search/{q}),结果直接合进上面的书源结果,可以一键加入书架;只会从这个书库自己的地址下载。书是 DSH 所在的机器去下载的:DSH 装在海外 VPS 上时,在中国大陆用手机打开面板,维基文库也能用;DSH 装在大陆、又不能访问外网的电脑上,维基文库连不上,只剩古腾堡。
-
导入:把文件拖进面板、选文件,或者填本机路径。支持的格式:
格式 怎么读 TXT 自动认编码:UTF-8、UTF-16、GBK / GB18030、Big5 EPUB 按书脊顺序,目录里的标题当章名(DRM 加密的读不了) PDF 取文字层,把版面折行接回段落(扫描版没有文字层,读不了) DOCX 标题样式当章节 Markdown / HTML #标题、<h1>当章节RTF / DOC 用 macOS 自带的 textutil 转换(只在 Mac 上) 纯文本按「第X章」「Chapter N」「序章」「尾声」这类标题分章;认不出标题的每约 8000 字分一个「第 N 部分」,方便跳转。
-
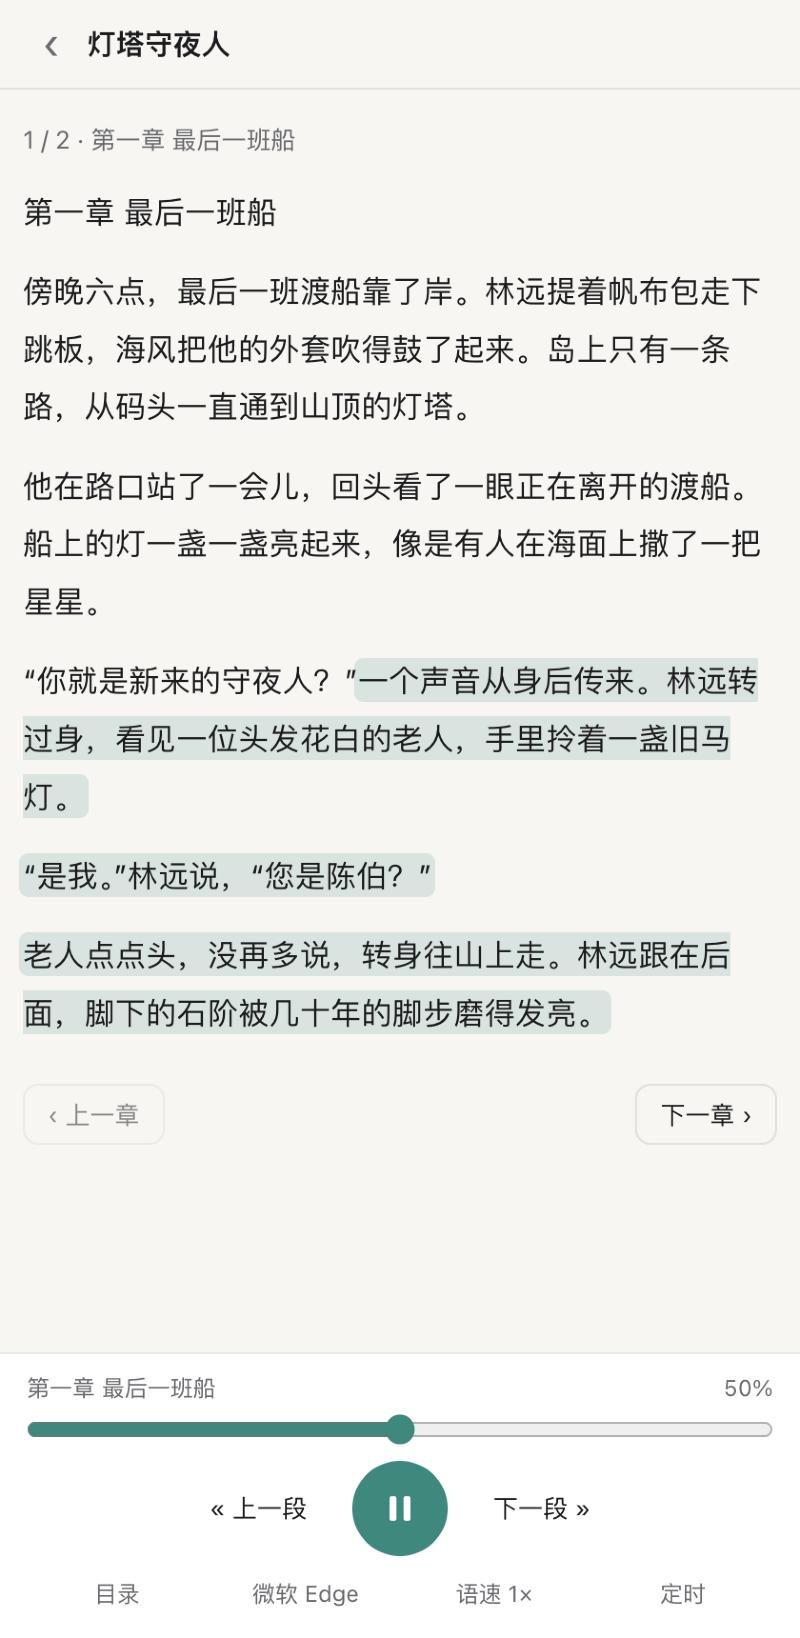
朗读(右侧栏「搜书听」页签,或手机浏览器直接打开):正文按约 20–30 秒一段切开,读到哪段高亮到哪段,点任意一段从那里读。
朗读方式 说明 浏览器朗读 不用安装,用这台设备自带的语音,文字不出这台设备。Mac 上在系统设置里下载「高级 / 增强」中文语音后会排在最前。手机锁屏后可能会停 微软 Edge 最自然。云希、晓晓、云健等 12 个中文声音(含台湾、粤语、方言),另有 6 个英文声音。调用开源工具 edge-tts,插件启动时自动装好,装在插件自己的目录里,不用管理员权限:有 Python 3 就用它(没有 venv / pip 也能装),连 Python 都没有就自动下载一份。要联网,文字会发到微软的服务器;这不是微软公开的正式接口,可能失效 本地离线 Kokoro 中文模型,55 个女声、45 个男声,完全离线。第一次用时下载约 147 MB 模型。比 Edge 生硬,合成也慢:开播的第一段要等十几秒,之后一边播一边提前合成 已经装了「听懂」的话,它下好的 Kokoro 中文模型和装好的 Edge 语音组件直接借用,不用再下。
-
语速:0.75× 到 2.5×。Edge 和本地语音由播放器加速,音调不变,换语速不用重新合成。
-
进度:每读一段存一次,存在服务器上和本机。关掉面板、换设备打开,都从上次的地方接着读。
-
🎙 记心得:听着听着有想法,点播放条右边的 🎙(自动暂停),按住说话、松开就转成文字(轻点一下就一直录,再点一下结束)。也可以直接打字。
- 每条心得挂在当时听到的位置:哪一章、哪一段原文,以后点一下就跳回去重听;正文里记过心得的地方有虚线标记
- 默认只存你的原话,想整理时点「AI 整理」:只去掉口头语、理顺句子、改同音错字,不改你的意思,原话也保留
- 每条心得自动有个简单明确的标题(比如「希斯克利夫阴沉又委屈」):记下时先按你的话顺手起一个,有模型就换成 AI 起的;点标题可以自己改,改过的 AI 不再动,清空就交回给 AI
- 每条都记着日期:显示成「今天 21:05」「昨天」「周三」「10月18日」
- 语音识别用 DSH 自带语音输入的同一套本地模型(SenseVoice),在 DSH 所在的机器上识别,声音不外传,识别完就删,只存文字。用过 DSH 语音输入的不用再下模型,没有的话第一次用时下载约 241 MB。手机上录音要用 HTTPS 打开面板
-
💬 问 AI:播放条左边的 💬,问刚听到的内容、人物关系、词语典故,或者聊聊你的想法;也能按住说话提问。
- AI 只看到本章开头到你正在听的这一段(再带一点上一章结尾);默认防剧透,问到后面会怎样它会说「还没读到」。勾「允许剧透」才放开
- 回答可以用当前选的声音读出来,有价值的一键「存为心得」;讨论记录每本书单独保存
-
心得本(播放条下面的「心得」,或者点正文里的 💭):可以按章节或按时间(今天、昨天、10月18日 周六……)看,心得多了能搜;编辑、AI 整理、导出 Markdown(带标题和日期)。删除不用确认,5 秒内可以撤销。
- 和 AI 聊聊我的心得:AI 看着你的心得和对应原文跟你讨论,帮你想得更深
- AI 写读后感:观点全部来自你的心得,AI 只负责组织成文
- 导入到…:自动发现能存笔记的地方,找到几个就出几个按钮,你自己选。会找:DSH 里能写笔记 / 知识库 / 记忆 / 日记的插件工具,起居注(当前 profile 装了 dsh-memex 时,写到它的日记目录),Obsidian 库,Logseq,Mac 的「备忘录」。什么都没装的话只有「导出 Markdown」。心得默认只存在插件里,点了才导入
-
我的心得(书库页):所有书的心得按日期放在一起看、一起搜(标题、内容、原文都能搜);「AI 帮我回顾」把最近 7 天 / 30 天的心得串起来,看看想法有什么呼应和变化。
-
书单:每本书右边的「⋯」可以改书名和作者、从头开始、删除。
-
其他:目录跳章、全书进度条拖动、定时停止(15 分钟到 1.5 小时,或读完本章停),锁屏界面和耳机线控(播放 / 暂停 / 上一段 / 下一段)。
电脑快捷键:空格 播放 / 暂停 · ← / → 上一段 / 下一段
在 DSH 对话里
插件给 AI 注册了 8 个工具,可以直接说:
- 「帮我找那本主角叫贾宝玉的书来听」:AI 自己判断书名,用
audiobook_search搜,audiobook_download下进书架 - 「把我读《呼啸山庄》的心得整理一下」「我最近一个月的读书心得有什么共同点」:
audiobook_notes - 「把这个想法记到心得里」:
audiobook_add_note - 「把 ~/Downloads/三体.epub 导入搜书听」:
audiobook_import - 「我在听哪些书?听到哪了?」:
audiobook_books - 「刚才那段讲了什么?」「阿青第一次出场在哪?」「把第三章讲给我听」:
audiobook_text,可以取刚听过的内容、在全书里找词、按章取正文 - 「跳到第十章」「跳到阿青出场的地方」:
audiobook_goto。面板没在播放时几秒内就会跟上新位置
更新 / 卸载:在 DSH 的「设置 → 搜书听」里。卸载只移除插件,书和收听进度留在 ~/.dsh/dsh-audiobook。
安装
装进 DSH(把 desktop 换成你的 profile 名;先完全退出 DSH):
dsh plugin --profile desktop add dsh-audiobook
重新打开 DSH,在对话页打开右侧栏,选「搜书听 · 读书给你听」。VPS 上的 DSH 一样装(以运行 DSH 的用户执行,再重启 DSH),手机浏览器打开 https://<你的域名>/api-dsh-audiobook/panel 就能听,点「选择文件」直接从手机里挑书(文件只传一次,服务器取出文字后就删掉原文件)。VPS 上建议用微软 Edge 或浏览器朗读:本地离线语音很吃 CPU,小 VPS 跟不上。前面有 nginx 的话,把 client_max_body_size 调大(默认只放行 1 MB)。
微软 Edge 语音组件会在插件启动后自动在后台装好(几秒到一分钟)。
ffmpeg 可选:有就把本地语音压成 MP3(隔着 VPS 用手机听更流畅),没有就直接给 WAV。
可选配置
在 profile 的 cordis.patch.yml 里:
- id: dsh-audiobook
  config:
    provider: dsh-model-workbuddy-ai   # 搜书时猜书名用的模型;不填就用 DSH 的默认模型
    model: workbuddy-ai/deepseek-v4.1-flash-sg
    edge: false                        # 不要自动安装 Edge 语音组件
    ffmpeg: /opt/homebrew/bin/ffmpeg   # 找不到 ffmpeg 时填
    threads: 2                         # 每个本地语音进程的线程数
    workers: 2                         # 同时开几个本地语音进程(每个占 300–400 MB 内存;VPS 内存小就设 1)
不开 DSH 也能用
npx dsh-audiobook import ~/Downloads/书.epub     # 导入
npx dsh-audiobook serve                          # 打开 http://127.0.0.1:4811
npx dsh-audiobook list
命令行版的模型(问 AI、整理心得、读后感、猜书名用):--base-url / --api-key / --model,或环境变量 AUDIOBOOK_BASE_URL / AUDIOBOOK_API_KEY / AUDIOBOOK_MODEL(任何 OpenAI 兼容接口);都没给就用本机的 dsh-model 网关。
数据
都在 ~/.dsh/dsh-audiobook/:
books/<书>/book.json:书名、作者、目录books/<书>/text.json:切好的朗读段books/<书>/progress.json:听到第几段books/<书>/notes.json:读书心得和读后感;books/<书>/chat.json:和 AI 的讨论记录settings.json:朗读方式、声音、语速edge-tts/:Edge 语音组件(Python 虚拟环境);没有 Python 的机器上还有uv/、python/cache/:合成好的声音,超过 500 MB 自动删最久没用的,可以随时整个删掉
同一本书换个位置再导入,还是同一本(编号按内容算),进度接得上。DSH 插件和命令行版共用这份数据。
开发
npm install
npm test
lib/extract.js各种格式取文字;lib/zip.js读 EPUB / DOCX 用的最小 ZIP 解包lib/segment.js分章、分句、切朗读段lib/speech.js服务器端合成:缓存、排队、预取(正在听的那段插队)lib/sources.js书源(古腾堡、维基文库)的搜索、下载和清理;lib/finder.js搜书(让模型按角色名、情节猜书名);lib/llm.js调 DSH 的模型lib/edge.jsEdge 语音组件(edge-tts)的自动安装和调用;lib/kokoro.js+lib/kokoro-worker.js本地中文语音的常驻子进程lib/store.js书库、进度、设置(原子写入的 JSON);lib/server.js面板接口plugin/DSH 宿主端(路由、AI 工具、更新卸载)和界面入口(右侧栏、设置);路由先过 DSH 的connection.requestRejection()登录校验lib/asr.js+lib/asr-worker.js语音输入(本地 SenseVoice 常驻子进程);lib/notes.js心得、问 AI、读后感、回顾;lib/targets.js发现可导入的知识库并导入web/朗读面板(原生 JS 模块,无构建):talk.js记心得、问 AI、心得本,recorder.js浏览器录音转 16 kHz WAV,panel.js书库和朗读页,player.js一段接一段地读(始终用同一个<audio>,下一段提前下载进内存:段间几乎不停顿,iPhone 锁屏后也能接着读)
Comments
Loading…